Uma atualização de programação chega com um serviço de pesquisa público
A DeepSeek lançou o V4.1-Flash-1017 a 17 de outubro de 2026, atualizando em simultâneo o seu site, aplicação e API, ao mesmo tempo que disponibilizou dois serviços que permitem aos programadores pesquisar na Web e obter páginas específicas. A empresa cobra $0,75 por cada 1.000 chamadas aos serviços Search e Fetch, com a cobrança das chamadas elegíveis através de ferramentas de servidor a começar às 16:00 UTC de 31 de outubro, ou à meia-noite de 1 de novembro em Pequim.
Índice
- Uma atualização de programação chega com um serviço de pesquisa público
- O que significa, na prática, programar a partir de um desejo
- Onde os ganhos nos testes de referência são maiores
- Porque é que respostas mais curtas podem reduzir o custo das tarefas
- A pesquisa encontra páginas; o Fetch obtém-nas
- Quanto vão pagar os programadores e a partir de quando
- Atualizações do Harness ligam o modelo ao trabalho quotidiano
- Pesos abertos e opções de implementação
- As datas que definem o lançamento
- Pontos principais
O lançamento surge 37 dias depois da estreia do V4.1 Flash, a 10 de setembro. Os programadores podem continuar a utilizar o nome de modelo deepseek-flash, sem alterações ao método de chamada da API do modelo nem aos preços existentes. A DeepSeek disponibiliza também o modelo atualizado em código aberto através do Hugging Face e do ModelScope.
O anúncio oficial do lançamento da DeepSeek coloca o desenvolvimento integral de projetos no centro da atualização. Entre os exemplos apresentados estão um modelo da Cidade Proibida de Pequim, um jogo de corridas para browser, uma recriação de Portal 2 com o motor Godot e uma cena 3D em movimento que percorre a história, desde a pré-história até à era moderna.
A DeepSeek afirma que o modelo tem melhor desempenho, demora menos tempo e produz respostas mais curtas. Para os programadores, estas alterações reduzem dois custos em simultâneo: o tempo durante o qual uma tarefa automatizada ocupa um computador e a quantidade de texto gerado faturada pelo serviço do modelo.
O lançamento da pesquisa acrescenta outra peça a este fluxo de trabalho. Uma aplicação de IA pode agora usar o modelo da DeepSeek para planear uma tarefa, o seu motor de pesquisa para encontrar informação atualizada e o serviço Fetch para incorporar na tarefa uma página Web selecionada.
O que significa, na prática, programar a partir de um desejo
A DeepSeek descreve a principal ambição do projeto como programar a partir de um desejo do utilizador: alguém explica em linguagem corrente o que pretende e a IA trata de uma parte maior do trabalho necessário para transformar esse pedido num projeto funcional.
As quatro demonstrações abrangem diferentes tipos de trabalho. O exemplo da Cidade Proibida centra-se na modelação 3D. O jogo de corridas exige interação com o browser. A recriação de Portal 2 utiliza um motor de jogo existente, o Godot. Valley of Ages apresenta ambientes em transformação ao longo de um extenso período da história humana.
A DeepSeek afirma que estes projetos foram criados no DeepSeek Harness com relativamente poucos comandos, material de referência limitado e poucas rondas de interação. A empresa atribui a melhoria à aprendizagem por reforço com autoavaliação, um método de treino em que o feedback sobre o trabalho realizado ajuda a moldar o comportamento futuro.
Um harness é o software que envolve um modelo de linguagem e gere ferramentas, ficheiros, sessões e a execução de tarefas. O modelo pode propor código ou decidir o que fazer a seguir; o harness proporciona o ambiente em que essas ações decorrem. Assim, o software envolvente passa também a fazer parte do processo de desenvolvimento do projeto, juntamente com o próprio modelo.
Onde os ganhos nos testes de referência são maiores
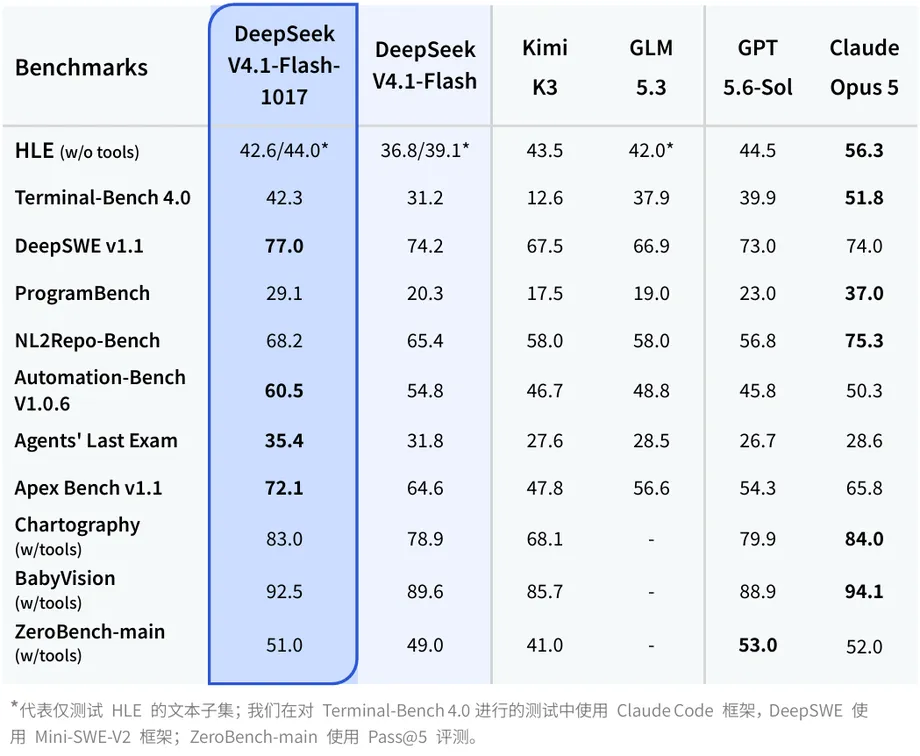
As avaliações publicadas pela DeepSeek atribuem ao modelo atualizado 77,0 pontos no DeepSWE v1.1, acima dos 74,2 pontos da versão de setembro. Trata-se de uma subida de 2,8 pontos numa avaliação de trabalho de engenharia de software. Na comparação da empresa, Claude Opus 5 obteve 74,0 pontos e GPT 5.6-Sol, 73,0.
O Terminal-Bench 4.0 revela uma melhoria mais acentuada face à versão Flash anterior: passou de 31,2 para 42,3, uma subida de 11,1 pontos. O ProgramBench subiu de 20,3 para 29,1, enquanto o NL2Repo-Bench aumentou de 65,4 para 68,2.
A DeepSeek apresenta também melhorias em tarefas que envolvem agentes, sistemas que recorrem a ferramentas para executar uma sequência de ações. O Automation-Bench v1.0.6 subiu de 54,8 para 60,5, o Agents' Last Exam de 31,8 para 35,4 e o Apex Bench v1.1 de 64,6 para 72,1.
Na tabela comparativa da DeepSeek, o modelo atualizado lidera no DeepSWE, Automation-Bench, Agents' Last Exam e Apex Bench, à frente dos modelos indicados da Anthropic, OpenAI, Kimi e Zhipu. Claude Opus 5 obtém resultados superiores em várias outras avaliações, incluindo Terminal-Bench, ProgramBench e NL2Repo.
As condições de teste são importantes para interpretar estes números. A DeepSeek indica 42,3 pontos no Terminal-Bench 4.0, enquanto uma avaliação da Artificial Analysis apresenta 26,8. Não são fornecidas as definições detalhadas necessárias para explicar a diferença. A DeepSeek identifica o Claude Code como ambiente para o Terminal-Bench e o Mini-SWE-V2 para o DeepSWE, ilustrando como o modelo e as ferramentas que o rodeiam são avaliados em conjunto.
Porque é que respostas mais curtas podem reduzir o custo das tarefas
A DeepSeek considera que a atualização representa uma melhoria de Pareto no desempenho e no custo. Em termos simples, a empresa afirma que os utilizadores obtêm melhores resultados gastando menos, em vez de trocarem maior qualidade por uma fatura mais elevada.
Os serviços de modelos cobram habitualmente por tokens, as pequenas unidades em que o texto é dividido para processamento. Uma resposta gerada mais curta usa menos tokens de saída. Um agente de programação pode gerar muitas respostas durante uma única tarefa, pelo que reduzir a produção desnecessária ao longo dessas etapas pode diminuir o custo total.
A DeepSeek afirma também que os tempos de execução das tarefas diminuíram. Isso é importante em projetos que envolvem edição, testes e utilização repetida de ferramentas, nos quais o utilizador espera por um resultado final, em vez de uma resposta isolada. A empresa descreve o lançamento técnico como uma pequena atualização, embora reivindique melhorias no raciocínio, na programação, nas tarefas de agentes e nas avaliações visuais.
A pesquisa encontra páginas; o Fetch obtém-nas
Os serviços Search e Fetch da DeepSeek têm funções distintas. O Search recebe uma consulta e devolve resultados ordenados. O Fetch recebe uma página Web específica e obtém o respetivo título e conteúdo em Markdown, um formato de texto simples que preserva títulos, listas e outras estruturas úteis.
Por exemplo, um programador poderia usar o Search para localizar documentação atualizada de software e, em seguida, o Fetch para obter a página relevante antes de pedir ao modelo que escrevesse código. As aplicações que combinam documentos obtidos com respostas geradas são frequentemente designadas por sistemas de geração aumentada por recuperação, ou RAG.
Os serviços usam o endereço base api.deepseek.com e o mesmo sistema de credenciais de API do serviço de modelos da DeepSeek. Os endpoints são POST /v1/tools/search e POST /v1/tools/fetch. Devolvem dados estruturados em JSON, que o software pode ler e fazer circular entre ferramentas.
O Search aceita consultas com um máximo de 128 caracteres. Os programadores podem pedir entre um e 50 resultados; por predefinição, são devolvidos 10. Os resultados podem incluir títulos, endereços, resumos breves, resumos mais extensos destinados a modelos, datas de publicação e, quando disponível, o conteúdo integral da página.
A DeepSeek afirma que o seu motor de pesquisa já suporta pesquisas no respetivo site e API e processa diariamente centenas de milhões de pedidos em todo o mundo. A empresa descreve um índice que abrange centenas de milhares de milhões de páginas Web e suporta pesquisas em vários idiomas.
A DeepSeek afirma também que filtra a manipulação da classificação dos resultados de pesquisa, as tentativas de influenciar a informação selecionada pela IA generativa e os conteúdos de baixa qualidade gerados por IA. Estas medidas visam a informação que um agente encontra antes de redigir uma resposta ou executar um pedido do utilizador.
Quanto vão pagar os programadores e a partir de quando
O anúncio em inglês da DeepSeek fixa o preço dos serviços Search e Fetch, individualmente, em $0,75 por cada 1.000 chamadas. Os preços em chinês são de 5 yuan por cada 1.000 chamadas de cada serviço. Assim, um fluxo de trabalho que faça uma pesquisa e obtenha uma página utiliza dois serviços faturados separadamente.
Segundo as regras de cobrança publicadas, o Search é cobrado quando devolve com sucesso uma lista de resultados não vazia. O Fetch é cobrado quando devolve o conteúdo da página com um estado de sucesso HTTP 200. Os pedidos falhados, os resultados vazios e os tempos limite não são cobrados; pedir mais resultados de pesquisa não altera o preço dessa chamada.
À taxa indicada em yuan, 1.000 pesquisas bem-sucedidas seguidas da obtenção de 1.000 páginas custariam 10 yuan em encargos de pesquisa e obtenção. O processamento do modelo é cobrado à parte. Esta separação ajuda os programadores a estimar o custo de um agente que pesquisa informação repetidamente durante o trabalho.
A DeepSeek afirma que as chamadas Search e Fetch feitas através de ferramentas de servidor no DeepSeek Harness, Claude Code e Codex são temporariamente gratuitas para os utilizadores da API DeepSeek. A faturação deste método começa às 16:00 UTC de 31 de outubro de 2026, exatamente à meia-noite de 1 de novembro em Pequim. A isenção temporária aplica-se a essas chamadas de ferramentas; os encargos habituais do modelo mantêm-se.
Cada conta pode fazer até cinco pedidos Search por segundo e cinco pedidos Fetch por segundo, com os dois limites contabilizados separadamente. O Fetch tem ainda limites adicionais para domínios individuais. Os pedidos que excedam a taxa permitida recebem uma resposta HTTP 429, que indica à aplicação que deve abrandar.
Atualizações do Harness ligam o modelo ao trabalho quotidiano
A DeepSeek recomenda o Harness v0.2.1-rc.1 ou posterior para o modelo atualizado. As letras rc identificam uma versão candidata, preparada para testes antes do lançamento final. O modelo foi especificamente otimizado para o DeepSeek Harness, o Tencent CodeBuddy, o WorkBuddy e outras frameworks.
O lançamento do Harness acrescenta formas de descobrir plugins em índices personalizados e de pedir a um agente que crie um plugin. Melhora também a gestão de dependências quando os plugins são ativados, desativados, atualizados ou removidos. Algumas alterações aos plugins podem produzir efeitos imediatamente; outras exigem um reinício.
Os programadores passam a dispor de interfaces para consultar e alterar o diretório de trabalho de uma sessão através dos kits de desenvolvimento de software para TypeScript e Python. Outras novidades incluem ferramentas experimentais para inspecionar sessões, suporte para diretórios de trabalho Git separados e ocultação automática de chaves e tokens encontrados em mensagens enviadas.
O lançamento dá continuidade ao trabalho na ponte Claude Code Mods, testada numa versão alfa anterior do Harness. Esse trabalho inicial tinha três exemplos executáveis e quatro exemplos bloqueados por interfaces ou capacidades de apresentação em falta. A camada de compatibilidade continua experimental e tem como objetivo declarado testar a integração das capacidades das extensões Claude Code nos plugins do Harness.
Os utilizadores que experimentam o Harness pela primeira vez recebem ainda 6 yuan em crédito promocional sem pagamento inicial. O crédito expira sete dias após a sua disponibilização e só está acessível enquanto houver saldo. O prazo curto torna-o numa pequena margem de teste para novos utilizadores.
Pesos abertos e opções de implementação
O anúncio oficial da DeepSeek confirma que o V4.1-Flash-1017 está disponível através do Hugging Face e do ModelScope. O lançamento mantém a licença MIT da linha V4.1 Flash, que permite uma utilização ampla, sujeita aos seus termos. Os programadores podem, assim, optar entre um serviço alojado e a operação do modelo nos seus próprios sistemas.
O V4.1 Flash aceita texto e imagens e gera texto. A sua arquitetura usa uma mistura de especialistas, o que significa que, em cada etapa de processamento, são ativadas partes selecionadas do modelo, em vez de todo o modelo trabalhar em cada token. As descrições da arquitetura indicam uma base de 552 mil milhões de parâmetros, dos quais 8 mil milhões são ativados durante o processamento da entrada e 16 mil milhões durante a geração da saída.
Uma janela de contexto de cerca de um milhão de tokens permite ao modelo trabalhar com grandes quantidades de material numa única sessão. Para um agente de programação, isso pode incluir instruções, ficheiros de código-fonte, conversas anteriores e resultados de ferramentas. A janela de contexto define a quantidade de informação que pode considerar, enquanto o limite de saída determina quanto pode gerar numa resposta.
As especificações da implementação alojada podem variar. Uma listagem de API de terceiros indica uma janela de contexto de 1.048.576 tokens e um máximo de 131.072 tokens por resposta, além de chamadas de funções e saídas estruturadas definidas por um esquema JSON. As chamadas de funções permitem ao modelo solicitar uma ferramenta externa; as saídas estruturadas dão à aplicação um formato previsível para processar.
A mesma listagem oferece encaminhamento através da inference.net, DeepInfra e DeepSeek, redirecionando pedidos para outro fornecedor quando um deles encontra um erro. Para os programadores, a escolha abrange agora o acesso ao modelo, o encaminhamento entre fornecedores e os serviços de pesquisa independentes, cada um com as suas próprias definições operacionais e custos.
As datas que definem o lançamento
O lançamento de outubro da DeepSeek combina uma atualização do modelo, uma versão candidata do Harness e o acesso público à infraestrutura de pesquisa. Mais cedo, a 17 de outubro, um serviço automatizado de monitorização de APIs detetou uma entrada de modelo com o sufixo 1017, que desapareceu posteriormente. O anúncio divulgado mais tarde pela DeepSeek confirmou o lançamento e a atualização do site, da aplicação e da API.
A sequência dá aos programadores um curto período para atualizarem as ferramentas e analisarem a utilização da pesquisa antes do fim do período temporário de gratuitidade:
- 10 de setembro de 2026: a DeepSeek lança o modelo original V4.1 Flash.
- 3 de outubro de 2026: o Harness v0.2.1-alpha.1 introduz a ponte experimental Claude Code Mods.
- 17 de outubro de 2026: o V4.1-Flash-1017 chega ao site, à aplicação e à API; o Search e o Fetch são disponibilizados aos programadores e fica disponível uma versão candidata atualizada do Harness.
- 31 de outubro de 2026, às 16:00 UTC: começa a cobrança das chamadas Search e Fetch elegíveis através de ferramentas de servidor, o que corresponde à meia-noite de 1 de novembro em Pequim.
Os programadores que já utilizam deepseek-flash recebem o modelo atualizado através do nome existente. Os utilizadores do Harness são também aconselhados a atualizar a aplicação envolvente. A alteração prática consiste num fluxo de trabalho mais integrado: um modelo treinado para projetos mais longos, ferramentas para executar o trabalho e um serviço de pesquisa que em breve terá uma tarifa de utilização própria.
Pontos principais
- A DeepSeek lançou o V4.1-Flash-1017 a 17 de outubro de 2026, no seu site, aplicação e API.
- O modelo continua disponível como deepseek-flash, sem alterações ao método de chamada da API do modelo nem aos preços existentes.
- A DeepSeek indica uma pontuação de 77,0 no DeepSWE v1.1, acima dos 74,2, além de tarefas mais rápidas e respostas mais curtas.
- As demonstrações de projetos incluem a modelação da Cidade Proibida, um jogo de corridas para browser, uma recriação de Portal 2 e Valley of Ages.
- O Search e o Fetch custam cada um $0,75, ou 5 yuan segundo os preços chineses, por cada 1.000 chamadas bem-sucedidas.
- A cobrança das chamadas elegíveis através de ferramentas de servidor começa a 1 de novembro, à meia-noite em Pequim.
- A DeepSeek recomenda o Harness v0.2.1-rc.1 ou posterior e disponibilizou os pesos do modelo através do Hugging Face e do ModelScope.