Um pequeno computador chinês de IA aponta a um rival dispendioso
A Sipeed pretende vender por cerca de 3.999 dólares um computador MaixStation com 128 GB de memória, baseado no AX8860P da fabricante chinesa de chips Axera. A máquina proposta mede apenas 11 por 11 por 3 cm e promete executar localmente grandes modelos de IA com um consumo típico de 40 watts. O rival que tem em vista é o DGX Spark da Nvidia, um sistema compacto de IA que custa cerca de 6.950 dólares na versão com 128 GB.
Índice
- Um pequeno computador chinês de IA aponta a um rival dispendioso
- O que a Axera integrou no AX8860P
- Porque é que 128 GB importam mais do que um valor TOPS de destaque
- A página oficial de testes comparativos apresenta um quadro mais limitado
- Porque é preciso comparar com cautela as alegações iniciais de velocidade
- Uma caixa de bolso com armazenamento normalizado
- Mais chips prometem capacidade, mas a escalabilidade ainda é uma alegação
- A promessa de software é fundamental para a utilização quotidiana
- O preço e a entrega estão agora dependentes de uma campanha
- Pontos principais
A Axera apresentou o chip numa feira industrial em Xangai, a 13 de outubro de 2026, ocasião em que a Sipeed também mostrou o MaixStation. A proposta inicial era impressionante: processamento de prompts 25% mais rápido e geração de respostas 30% mais rápida do que no DGX Spark, ao executar um modelo Qwen com 27 mil milhões de parâmetros, por cerca de metade do preço.
A página do produto MaixStation da Sipeed apresenta agora informações mais detalhadas. Indica velocidades de 592 a 677 tokens por segundo no processamento de prompts com o Qwen3.8-27B e de 6 a 7 tokens por segundo na geração de respostas. Estes valores são inferiores aos intervalos divulgados em torno do anúncio, enquanto o plano oficial de lançamento prevê uma campanha no Kickstarter para o final de 2026.
A proposta é concreta: uma grande capacidade de memória num computador pequeno poderá permitir a programadores, escritórios e utilizadores individuais executar modelos capazes sem recorrer a serviços de computação na nuvem ou comprar várias placas gráficas. No entanto, a decisão de compra dependerá tanto do software final, do desempenho medido e do calendário de entrega como das especificações do chip.
O que a Axera integrou no AX8860P
A família AX8860 utiliza um processo de fabrico de 6 nanómetros e combina 16 núcleos de CPU Arm Cortex-A55 com uma unidade de processamento neural dedicada, ou NPU. Uma NPU é um processador concebido para executar os cálculos repetidos utilizados pelos modelos de IA. A Axera e a Sipeed indicam um desempenho máximo de 256 biliões de operações por segundo, habitualmente abreviado para 256 TOPS, em FP4.
O formato FP4 representa valores numéricos com quatro bits de precisão. A utilização de menos bits reduz a memória necessária para um modelo e pode acelerar os cálculos, embora o modelo e o software tenham de suportar esse formato. O valor indicado pela Axera refere-se a computação densa, não a um cálculo que pressuponha que alguns valores podem ser ignorados através de uma técnica chamada esparsidade.
O chip suporta PCIe 5.0 e uma interface de memória com 256 bits de largura. A Sipeed especifica memória LPDDR5X-8533, até 128 GB por módulo, e uma largura de banda de 273 GB por segundo. O seu módulo Maix-V mede 78 por 78 mm e utiliza um conector LPCAMM2.
Os núcleos Cortex-A55 tratam do sistema operativo e das tarefas de suporte, enquanto a NPU se destina à principal carga de trabalho de IA. O DGX Spark da Nvidia tem 20 núcleos Arm, incluindo os mais potentes Cortex-X925, enquanto as máquinas concorrentes AMD Ryzen AI Halo utilizam CPUs Zen 5. Por isso, os utilizadores que planeiam combinar inferência de IA com uma carga significativa de computação convencional têm mais aspetos a comparar do que apenas o acelerador.
Porque é que 128 GB importam mais do que um valor TOPS de destaque
Um modelo de linguagem precisa de memória para os seus pesos numéricos, que codificam o que aprendeu durante o treino, e para os dados de trabalho criados enquanto responde a um pedido. Um acelerador rápido com pouca memória pode obrigar a dividir o modelo por vários dispositivos ou a transferi-lo através de armazenamento mais lento.
A configuração proposta de 128 GB do MaixStation coloca-o na mesma categoria de capacidade de memória do DGX Spark, de maiores dimensões. Ambos indicam uma largura de banda de 273 GB por segundo. A gama Ryzen AI Halo da AMD inclui uma configuração com 128 GB e cerca de 256 GB por segundo, bem como uma versão mais cara com 192 GB e 273 GB por segundo.
A capacidade determina a quantidade de dados que cabe na memória. A largura de banda determina a rapidez com que a informação chega ao processador. Durante a geração normal de texto por um modelo de linguagem denso, cada novo token exige a leitura de grandes quantidades de dados do modelo. Um token é uma pequena unidade de texto, por vezes uma palavra e por vezes apenas parte de uma palavra.
Por isso, a Sipeed defende que uma utilização eficaz da memória pode permitir ao seu processador de 256 TOPS competir com o valor de computação mais elevado anunciado pela Nvidia. A classificação de cerca de 1.000 TOPS FP4 do DGX Spark utiliza esparsidade; o seu valor FP4 em computação densa é de cerca de 500 biliões de operações por segundo. A velocidade real nas aplicações também depende da eficiência com que o software mantém o hardware ocupado.
A página oficial de testes comparativos apresenta um quadro mais limitado
A Sipeed divide os testes em prefill, quando o modelo processa o prompt do utilizador, e decode, quando gera uma resposta. Um prefill mais rápido pode reduzir a espera até ao início da resposta, sobretudo no caso de documentos longos. Um decode mais rápido faz com que a resposta apareça mais depressa depois de começar a ser gerada.
Para o Qwen3.8-27B em FP4 denso, a página oficial indica um prefill de 592 a 677 tokens por segundo no MaixStation, contra 550 no DGX Spark. Isto representa uma vantagem de cerca de 8% a 23%. A velocidade de decode indicada para o MaixStation é de 6 a 7 tokens por segundo, mas o texto fornecido do gráfico oficial não apresenta um valor numérico de referência para o decode do DGX Spark com esse modelo.
Para o Qwen3.6-35B-A3B, um modelo de mistura de especialistas, a Sipeed indica um prefill de 2.664 a 3.256 tokens por segundo, contra 2.368 no DGX Spark. A vantagem calculada é de cerca de 13% a 38%. O decode é de 34 a 37 tokens por segundo, contra 34, o que corresponde a um empate ou a uma vantagem de cerca de 9%.
Um modelo de mistura de especialistas ativa apenas parte da sua rede para cada token. Isso ajuda a explicar por que razão a sua velocidade de geração pode ser muito superior à de um modelo denso com um número total de parâmetros semelhante. Os dois tipos de modelo envolvem diferentes quantidades de trabalho por token.
A Sipeed descreve os resultados apresentados como medições atuais conservadoras e afirma que o AX8860P continua a ser afinado. O gráfico especifica FP4 com a previsão de vários tokens, ou MTP, desativada. A MTP é uma técnica que propõe vários tokens futuros em conjunto para acelerar a geração.
Porque é preciso comparar com cautela as alegações iniciais de velocidade
Os intervalos de desempenho anteriormente publicados pela Sipeed eram superiores: 1.400 a 1.600 tokens por segundo no prefill do Qwen3.8-27B e 15 a 17 no decode, contra valores de referência de 1.300 e 13 no DGX Spark. Para o modelo de mistura de especialistas, os intervalos eram de 6.300 a 7.700 no prefill e 80 a 88 no decode, contra 5.600 e 80. A Sipeed também apresentou posteriormente uma comparação que colocava o MaixStation cerca de 10% à frente em ambas as fases, afirmando que os testes mais recentes, com uma vantagem maior, não eram oficiais.
Os valores absolutos mais baixos da página oficial tornam especialmente relevantes as condições dos testes. O comprimento do prompt, o número de pedidos processados em simultâneo, os formatos numéricos, o software de execução e as versões dos controladores podem alterar os resultados. Testes independentes do DGX Spark citados na cobertura noticiosa chegaram a cerca de 11,5 a 11,6 tokens por segundo no Qwen3.8-27B sem descodificação especulativa, enquanto o prefill variou entre 840 e 1.900 consoante o software.
Um cálculo simples de memória ajuda a perceber a atenção dada à alegação inicial de 17 tokens por segundo. Se o modelo em execução ocupar cerca de 16 GB, dividir 273 GB por segundo por 16 GB dá aproximadamente 17 tokens por segundo, antes de contabilizar outro tráfego de memória. Para atingir essa velocidade, seria necessário aproveitar de forma excecionalmente elevada a largura de banda anunciada.
Aqui, é importante conhecer a memória efetivamente ocupada pelo modelo. Quatro bits multiplicados por 27 mil milhões de parâmetros correspondem a cerca de 13,5 GB só para os pesos, mas os dados de escala numérica e outros elementos de armazenamento podem aumentar o espaço de trabalho necessário. Testes detalhados e reproduzíveis permitiriam aos compradores relacionar os valores de velocidade com uma configuração específica do modelo.
Uma caixa de bolso com armazenamento normalizado
As dimensões anunciadas do MaixStation correspondem a um volume de 363 centímetros cúbicos. A Sipeed compara-o com os 1.125 centímetros cúbicos do DGX Spark, pelo que a caixa proposta terá cerca de um terço do volume. A empresa afirma que o computador pode ser alimentado por USB-C através de uma bateria externa adequada, com uma potência nominal de 65 watts.
A página oficial indica um consumo típico de 40 watts para o MaixStation e de 120 watts para o DGX Spark. São valores de carga típica declarados pela Sipeed. A cobertura inicial do AX8860 indicava também 40 watts para o módulo dedicado, pelo que o âmbito das medições de consumo será outro pormenor útil a esclarecer em futuros testes.
As ligações incluem rede 10G SFP+, USB-C, um conector MCIO 8i e uma ranhura M.2 2280 normalizada para um SSD. Este formato de armazenamento oferece aos compradores uma forma familiar de acrescentar espaço para ficheiros de modelos, que podem rapidamente ocupar centenas de gigabytes.
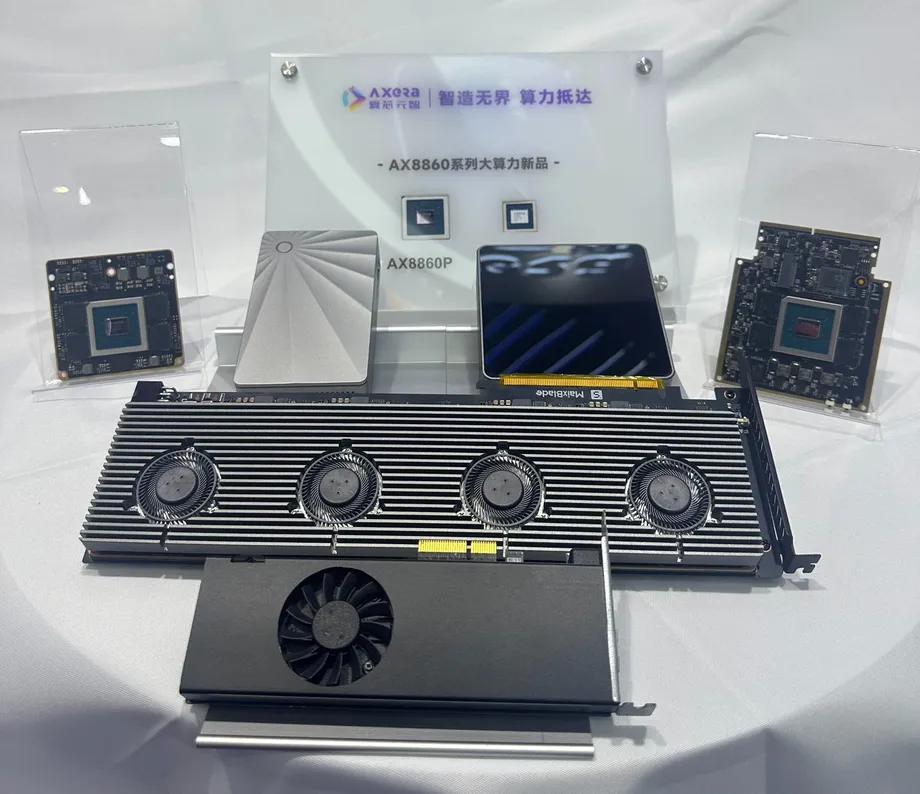
Os planos de hardware da Axera vão além do pequeno computador de secretária. Incluem um módulo, uma placa PCIe com um chip e outra placa com quatro chips, quatro ventoinhas e um conector de alimentação normalizado de oito pinos. A Sipeed associa o MaixStation Pro e o MaixBlade a configurações com 512 GB ou mais.
Mais chips prometem capacidade, mas a escalabilidade ainda é uma alegação
A Sipeed afirma que o MaixStation pode ligar até oito nós sem um comutador externo, através de uma ligação entre chips com uma velocidade nominal de 256 gigabits por segundo, expansível até 384 gigabits por segundo. O DGX Spark utiliza uma ligação de 200 gigabits para interligar sistemas, e uma configuração com quatro unidades Spark exige um comutador externo.
A distinção entre gigabits e gigabytes é importante. Uma ligação com uma velocidade nominal de 256 gigabits por segundo corresponde a 32 gigabytes por segundo em bruto, antes de contabilizar a sobrecarga. A largura de banda de memória de 273 gigabytes por segundo refere-se a uma ligação diferente e muito mais rápida no interior de cada máquina.
A Axera indica 512 TOPS no total para dois chips e 1.024 TOPS para quatro, além de alegar uma eficiência de escalabilidade de cerca de 80%. O valor de escalabilidade para quatro chips resulta de uma simulação de laboratório. A distribuição de um modelo por vários processadores também implica trabalho de comunicação e sincronização, pelo que a velocidade nas aplicações depende de mais fatores do que a simples soma dos valores máximos de computação.
O roteiro da Axera prevê o AX8950, com até 500 TOPS, e o AX8970, com mais de 700 TOPS. Estes processadores planeados poderão permitir futuras atualizações, mas a proposta imediata do MaixStation assenta no AX8860P e no respetivo software.
A promessa de software é fundamental para a utilização quotidiana
A Sipeed indica Debian 13 com Linux 6.18, além de suporte para vLLM, SGLang, PyTorch, llama.cpp e Ollama. Estas ferramentas ajudam a carregar modelos, processar pedidos e ligar aplicações de IA ao hardware. A empresa anuncia também APIs compatíveis com OpenAI e Anthropic, permitindo que as aplicações existentes enviem pedidos para um dispositivo local.
As perguntas frequentes sobre o produto da Sipeed explicam que os nomes conhecidos das frameworks assentam em software desenvolvido para o hardware da Axera:
O SGLang e o vLLM funcionam através de um backend personalizado de aceleração de hardware, cujos kernels são escritos em AXDSL.
Os kernels são pequenos blocos de software que executam cálculos essenciais no acelerador. A Sipeed afirma que os utilizadores podem carregar diretamente modelos Hugging Face compatíveis, enquanto novas arquiteturas de modelos poderão exigir kernels escritos em AXDSL. A empresa promete publicar kernels e ferramentas de desenvolvimento e afirma estar a trabalhar na abertura do kit de desenvolvimento de software AX8860.
A empresa anuncia modelos e uma interface de navegador prontos a utilizar desde o arranque. Entre as utilizações sugeridas estão agentes de programação, processamento de documentos, geração de vídeo e robótica. O suporte para anfitriões Linux chega primeiro para as placas PCIe; o suporte para Windows dependerá da procura. Na altura do anúncio, previa-se que a cadeia de ferramentas da NPU estivesse disponível até ao final de outubro.
O preço e a entrega estão agora dependentes de uma campanha
O preço previsto pela Sipeed, de 3.999 dólares para 128 GB, seria cerca de 2.951 dólares, ou 42%, inferior ao do DGX Spark, que custa 6.950 dólares. Trata-se de um desconto substancial, embora não chegue a metade do preço. O MaixStation ficaria também próximo dos cerca de 3.999,99 dólares do AMD Ryzen AI Halo com 128 GB.
O calendário de lançamento mudou face à expectativa inicial de que os dispositivos chegassem durante 2026. As reservas já estão abertas, mas as perguntas frequentes oficiais apontam para uma campanha no Kickstarter no final de 2026. A Sipeed afirmou que pretende iniciar as expedições nos três meses seguintes ao encerramento da campanha.
- 13 de outubro de 2026: a Axera apresentou a família AX8860 em Xangai e a Sipeed mostrou o MaixStation.
- Final de outubro de 2026: a Sipeed previa disponibilizar a cadeia de ferramentas da NPU.
- Final de 2026: a Sipeed planeia lançar a campanha do MaixStation no Kickstarter.
- Nos três meses seguintes ao encerramento da campanha: prazo de expedição indicado pela Sipeed.
A Sipeed ainda não confirmou o preço final de venda, uma data firme de entrega ou o desempenho do MaixStation verificado de forma independente. A capacidade de produção, as condições de assistência e o preço e calendário da versão Pro de 512 GB também continuam por definir. Está previsto disponibilizar acesso remoto e unidades para análise durante a campanha, dando aos potenciais compradores uma próxima oportunidade de avaliar as alegações.
Pontos principais
- O MaixStation pretende custar cerca de 3.999 dólares, com 128 GB de memória e um processador Axera AX8860P classificado em 256 TOPS em FP4 denso.
- A Sipeed indica uma largura de banda de memória de 273 GB por segundo, um consumo típico de 40 watts e uma caixa com 11 por 11 por 3 cm.
- A página oficial de testes comparativos apresenta velocidades absolutas inferiores às dos intervalos anteriormente publicados, com resultados que variam consoante o modelo e a fase de processamento.
- O suporte de software depende de um backend personalizado de aceleração da Axera, com ferramentas de desenvolvimento e mais código prometidos para publicação.
- A campanha no Kickstarter está prevista para o final de 2026, seguindo-se um prazo de expedição indicado de até três meses após o seu encerramento.
- Os testes independentes, os preços finais e os compromissos de entrega determinarão a comparação do sistema proposto com as alternativas da Nvidia e da AMD.