Uma GPU funcional e uma alegação de 5% mais débito
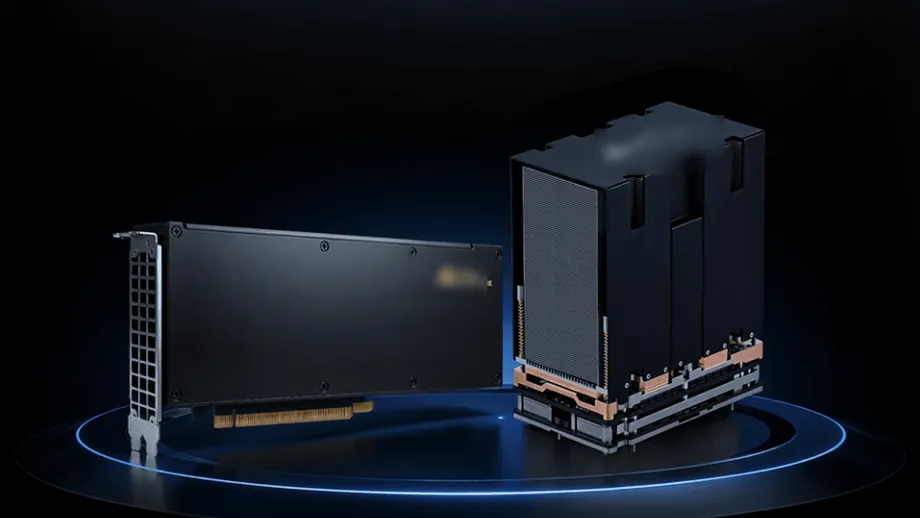
A Iluvatar CoreX demonstrou publicamente o seu processador gráfico Tiangai 300 em Xangai, apresentando-o como uma alternativa chinesa ao H200 da Nvidia, com uma alegada vantagem de 5% num teste de inferência realizado por terceiros. No seu dia aberto à comunicação social, a 28 de outubro de 2026, a empresa mostrou também um sistema de treino com oito GPU e descreveu uma rack com 144 GPU e 18 CPU.
Índice
- Uma GPU funcional e uma alegação de 5% mais débito
- O que mede a comparação com o H200
- Documentos longos e respostas iniciais mais rápidas
- Os resultados de treino usam outra referência da Nvidia
- Do lançamento em julho à demonstração de outubro
- Uma rack concebida para 144 GPU
- Partilhar tarefas de IA entre diferentes chips
- Alegações sobre software visam reduzir o tempo de implementação
- TY1200 alarga a proposta aos robôs
- Principais pontos
A comparação em destaque baseia-se em testes concluídos em julho pelo Shanghai Electric Group, segundo a Iluvatar CoreX. Numa implementação que separou duas etapas do processamento de modelos de linguagem de grande dimensão, o Tiangai 300 alcançou um débito de ponta a ponta equivalente a 1,05 vezes o do H200, depois de os resultados serem convertidos num valor por placa.
Débito significa a quantidade de trabalho útil que um sistema conclui num determinado período. Num chatbot, pode corresponder ao número de segmentos de texto que gera por segundo. Um resultado de 1,05 vezes o desempenho de referência significa mais 5% de produção nas condições desse teste.
A empresa descreveu o Tiangai 300 como a primeira GPU chinesa de uso geral a atingir o desempenho do H200 em testes medidos. A demonstração de outubro alargou a comparação a modelos de linguagem, geração de imagens e geração de vídeo, enquanto uma demonstração de treino separada usou o H100 da Nvidia como referência.
O evento apresentou mais do que as especificações de um chip. A Iluvatar CoreX mostrou placas, servidores, uma rack de alta densidade, ferramentas de software e um método de partilha de tarefas de IA entre diferentes tipos de processadores. A proposta comercial da empresa é que estes componentes permitam produzir resultados úteis de IA a menor custo e com menos tempo de espera.
O que mede a comparação com o H200
O teste de julho do Shanghai Electric Group recorreu à separação entre prefill e decode, muitas vezes abreviada para separação PD. O prefill é a etapa em que um modelo de linguagem lê o pedido do utilizador e os materiais de apoio. O decode é a etapa em que gera uma resposta, um token de cada vez. Os tokens são as pequenas unidades em que os sistemas de IA dividem o texto.
Separar estas etapas permite atribuir recursos de forma diferente à leitura e à escrita. O resultado do Tiangai 300 diz, por isso, respeito a uma configuração de implementação específica, com o desempenho total expresso como um valor equivalente por placa.
A Iluvatar CoreX não tinha publicado o método de teste detalhado, a lista de modelos nem as condições das cargas de trabalho que sustentam o resultado de terceiros em destaque. Esses elementos, juntamente com o cálculo de conversão e as definições do software, são necessários para uma reprodução independente. A comparação de custos também não tem uma discriminação publicada, e os valores da memória das placas individuais e da rack completa precisam de ser esclarecidos.
As demonstrações identificadas pelo laboratório de desempenho dão uma imagem mais detalhada das alegações da empresa. Descrevem melhorias diferentes para tarefas diferentes, desde um pequeno ganho na geração multimédia a um aumento mais expressivo do débito de recomendações. Para um comprador, a comparação relevante é a tarefa que o seu próprio serviço executa.
Documentos longos e respostas iniciais mais rápidas
O desempenho do Tiangai 300 em operações de atenção atingiu 1,05 vezes o do H200 com um comprimento de contexto de 64K, segundo o laboratório da empresa. A atenção é o processo que ajuda um modelo a determinar que partes dos dados de entrada são relevantes entre si. Um comprimento de contexto de 64K significa que o modelo está a processar cerca de 64 000 tokens.
No GLM-5.3, com a mesma escala de contexto, a Iluvatar CoreX declarou um débito de 1,15 vezes o desempenho do H200, mantendo uma experiência de utilização equivalente. Isso representa um aumento de 15% na carga de trabalho de mistura de especialistas testada. Um modelo de mistura de especialistas encaminha o trabalho para redes especializadas selecionadas, em vez de usar todas as redes para cada token.
Para cargas de trabalho de agentes de IA com contextos entre 8K e 128K, a empresa indicou uma redução de cerca de 10% a 30% no tempo de espera pelo primeiro token de saída. Esta medida é importante para quem espera que um assistente comece a responder depois de ler um documento extenso ou processar um pedido complexo.
A geração de imagens e vídeos foi outra componente da demonstração. A empresa indicou um aumento de cerca de 2% a 5% no débito de geração multimodal em comparação com o H200. Em cargas de trabalho de pesquisa em linha, publicidade e recomendação, reivindicou um débito de inferência de recomendação 21% superior e uma latência 26% inferior em computação ligeira.
Os resultados de treino usam outra referência da Nvidia
A demonstração de treino usou o Qwen3-32B, um modelo com cerca de 32 mil milhões de parâmetros, num servidor com oito GPU. Os parâmetros são os valores numéricos que um modelo ajusta durante o treino para aprender padrões. A Iluvatar CoreX afirmou que o débito efetivo por placa atingiu 1,33 vezes o do H100 da Nvidia.
A vantagem indicada foi, portanto, de 33% nessa demonstração de treino, tendo o H100 como chip de comparação. Os resultados de inferência apresentados noutras partes do evento usaram o H200. É essencial manter estes produtos de referência separados para interpretar os números.
O sistema de treino funcionou com precisão FP8. O FP8 armazena números usando oito bits, reduzindo a quantidade de dados que têm de ser transferidos e processados em comparação com formatos que usam mais bits. O software de treino de IA tem de gerir cuidadosamente esta precisão inferior para preservar a qualidade da aprendizagem.
A Iluvatar CoreX indicou também uma variação do tempo por etapa de 0,43% durante funcionamento prolongado à carga máxima, em comparação com 0,76% num sistema de referência baseado na arquitetura Hopper. O tempo por etapa é o tempo necessário para concluir uma unidade de trabalho repetida. Uma temporização mais consistente pode ajudar os operadores a prever quanto trabalho um sistema ocupado conseguirá concluir.
Do lançamento em julho à demonstração de outubro
O Tiangai 300 foi apresentado oficialmente na Conferência Mundial de Inteligência Artificial, em julho de 2026. Utiliza a arquitetura Tianshu da empresa, integra uma nova geração de Tensor Cores e tem uma capacidade especificada de 144 GB de memória gráfica.
O processador suporta operações escalares, vetoriais e tensoriais. Em termos simples, estas tratam números individuais, grupos de números e matrizes matemáticas de maior dimensão. Os formatos numéricos suportados incluem FP4, FP8, FP16 e BF16, dando aos programadores de software diferentes opções em termos de velocidade, utilização de memória e precisão numérica.
Os marcos públicos descritos pela empresa abrangem vários meses:
- Julho de 2026: o Tiangai 300 foi lançado na Conferência Mundial de Inteligência Artificial.
- Julho de 2026: o Shanghai Electric Group concluiu o teste de terceiros citado na comparação de débito com o H200.
- Antes do evento para a comunicação social em outubro: a conceção da rack IXL144 foi apresentada na Feira Internacional da Indústria da China.
- 28 de outubro de 2026: a Iluvatar CoreX abriu à comunicação social, em Xangai, demonstrações ao vivo do hardware Tiangai 300.
O evento de outubro passou das apresentações de arquitetura para sistemas a executar cargas de trabalho identificadas. A gama de implementações descrita pela empresa estende-se agora das placas aceleradoras individuais a servidores com oito placas e ao sistema IXL144 de maior dimensão.
Uma rack concebida para 144 GPU
A IXL144 combina 144 GPU e 18 CPU numa rack normalizada, com cerca de 10,1 TB de memória agregada de GPU, segundo a Iluvatar CoreX. A empresa descreveu-a como o supernó de GPU mais denso da indústria alojado numa única rack. Um supernó liga estreitamente muitos processadores para que possam colaborar em tarefas de grande dimensão.
A especificação indicada de 144 GB por Tiangai 300 e os 10,1 TB totais declarados para a rack exigem uma discriminação mais clara da configuração. Multiplicar 144 placas por 144 GB dá 20 736 GB, antes de ter em conta diferenças na forma de contabilizar a capacidade. A descrição da rack tem de especificar a configuração das placas e a capacidade de memória disponível para as cargas de trabalho.
A Iluvatar CoreX estima que o sistema pode reduzir em cerca de 40% o custo por milhão de tokens efetivos, em comparação com sistemas internacionais generalizados. Tokens efetivos são os tokens de saída contabilizados como trabalho útil. Para os operadores que vendem serviços de IA, esta medida relaciona o investimento em hardware com a quantidade de resultados utilizáveis produzidos.
Uma redução de 40% significaria um custo de 60 unidades por um trabalho que custa 100 unidades no sistema de referência. A poupança efetiva dependerá do preço do equipamento, do consumo de energia, do software, da carga de trabalho e da regularidade com que as GPU se mantêm ocupadas.
A empresa descreveu também um objetivo para o seu motor de interligação ponto a ponto da próxima geração: reduzir uma transferência única dentro do domínio ligado de 3 a 5 microssegundos para 1 microssegundo. Uma comunicação mais rápida é útil quando diferentes GPU contêm partes distintas de um modelo e têm de trocar dados repetidamente.
Partilhar tarefas de IA entre diferentes chips
A abordagem de implementação heterogénea da Iluvatar CoreX atribui diferentes partes da inferência a diferentes tipos de processadores. No âmbito do seu esquema de separação AFD, o Tiangai 300 trata de toda a etapa de prefill e dos cálculos de atenção durante o decode. O XPU de um parceiro trata das redes de especialistas feed forward.
XPU é uma designação abrangente para outro tipo de acelerador informático. A ideia subjacente é atribuir a cada processador o trabalho que executa melhor, enquanto um escalonador comum coordena a tarefa completa. As redes feed forward executam outra parte importante do processamento matemático no interior de um modelo de linguagem.
A empresa indicou uma redução de 60% na latência de inferência durante o decode com escalonamento unificado. Trata-se de uma configuração de sistema diferente da vantagem de débito de 5% em relação ao H200, em que se usa uma medida de desempenho distinta.
Shan Tianyi, responsável pela área de IA e computação acelerada da empresa, afirmou que os futuros sistemas de computação para IA dependerão da organização eficiente de diferentes chips, em vez de recorrerem a um único tipo de processador para todas as tarefas. A demonstração AFD concretiza essa estratégia numa configuração com GPU e aceleradores de um parceiro.
Alegações sobre software visam reduzir o tempo de implementação
A Iluvatar CoreX apresentou também uma pilha de software de IA para IA, concebida para automatizar partes da implementação e da otimização. A empresa afirmou que uma tarefa de configuração do ambiente passou de uma hora para 10 minutos, enquanto o número de operações manuais caiu de várias dezenas para uma.
Num trabalho de otimização de um modelo de grande dimensão, a empresa indicou ter reduzido o ciclo de trabalho de sete dias para menos de duas horas, com um desempenho próximo do dobro do nível anterior. Estes exemplos dizem respeito ao trabalho de engenharia necessário para executar modelos de forma eficiente no hardware.
A empresa reivindicou também uma integração profunda com o FlyDSL, uma linguagem usada para desenvolver rotinas de computação para GPU. Afirmou que a velocidade de compilação aumentou mais de 90% e descreveu um fluxo de trabalho que antes exigia um dia de trabalho de 10 pessoas e que passou a ser concluído por uma pessoa em poucas horas.
O suporte de software é importante porque um processador precisa de mais do que hardware capaz de efetuar cálculos. Os modelos, as bibliotecas matemáticas e as ferramentas de implementação têm de funcionar em conjunto. As demonstrações de software abordam o esforço de engenharia de que os clientes poderão precisar antes de transformarem uma nova GPU num serviço operacional.
TY1200 alarga a proposta aos robôs
O evento de Xangai incluiu também o Tongyang TY1200, um processador distinto destinado a PC com IA e à inteligência incorporada, incluindo robôs que detetam e atuam no mundo físico. A capacidade de computação densa indicada é de 300 TOPS, ou 300 biliões de operações por segundo. A computação densa contabiliza trabalho sem depender de cálculos ignorados que envolvem valores zero.
A Iluvatar CoreX afirmou que o TY1200 atingiu 1,2 vezes o desempenho do Thor T5000 da Nvidia em testes com os modelos Qwen3.8-27B e Qwen3.6-35B-A3B. Para os modelos Cosmos-R2-2B e Cosmos-R2-8B em cenários de IA física, indicou um desempenho equivalente a 158% e 180% do valor de referência do Thor T5000, respetivamente.
A empresa afirmou ainda que o TY1200 pode executar simulações físicas aceleradas por GPU com o MuJoCo-Warp. Isso permite a um sistema de desenvolvimento robótico simular movimentos, treinar uma política de controlo e verificar ações localmente. Uma política de controlo é o conjunto de instruções aprendidas que um robô usa para decidir como se mover.
Entre as aplicações indicadas estão robôs que assistem pessoas durante consultas médicas, visão industrial e orientação de visitantes. O sucessor previsto, TY2000, tem uma capacidade de computação-alvo indicada de 600T. Em conjunto, estes produtos alargam a estratégia da empresa dos grandes servidores de IA a equipamentos que funcionam junto dos utilizadores e das máquinas.
Principais pontos
- A Iluvatar CoreX demonstrou o hardware Tiangai 300 em Xangai, a 28 de outubro de 2026.
- A empresa citou testes do Shanghai Electric Group que indicaram um débito por placa equivalente a 1,05 vezes o desempenho do H200 da Nvidia.
- Uma demonstração de treino do Qwen3-32B com oito GPU terá alcançado um débito por placa de 1,33 vezes o do H100, com precisão FP8.
- O método detalhado por detrás do principal teste de desempenho realizado por terceiros não foi publicado.
- A rack IXL144 contém 144 GPU e 18 CPU, com uma alegada redução de 40% no custo por milhão de tokens efetivos.
- Uma implementação separada, que partilha tarefas entre GPU e XPU, terá reduzido a latência de decode em 60%.
- O evento abordou também a automatização por software e as aplicações do TY1200 em IA local e simulação robótica.