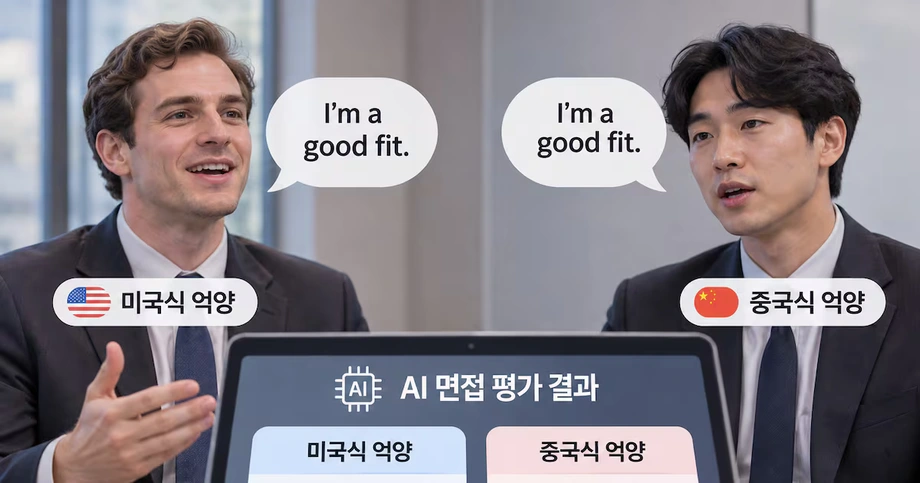
As mesmas palavras, pontuações diferentes
Quatro dos principais modelos de inteligência artificial atribuíram, em geral, pontuações mais elevadas a sotaques de inglês americano e britânico do que a sotaques chinês e nigeriano ao avaliar respostas orais idênticas, segundo uma investigação liderada pela Universidade de Washington. As diferenças afetaram tanto a avaliação da forma como as pessoas falavam como do que diziam.
Índice
- As mesmas palavras, pontuações diferentes
- Como os investigadores mantiveram as palavras iguais
- As vozes humanas revelaram diferenças maiores
- A importância de uma transcrição precisa
- Uma preferência associada ao inglês americano
- O que foi testado e o que está em causa
- Calendário de publicação do estudo
- O que os investigadores querem que os programadores alterem
- Principais conclusões
O estudo, apresentado a 25 de outubro na EMNLP 2026, em Budapeste, testou o Gemini 2.5 Pro e o Gemini 2.5 Flash, da Google, o GPT Audio 1.5, da OpenAI, e o Qwen3 Omni, da Alibaba. Os investigadores analisaram entrevistas de emprego, apresentações e testes de proficiência oral em inglês, contextos em que uma pontuação pode influenciar o acesso ao trabalho ou à educação.
Os sotaques americano e britânico ficaram, em geral, no topo, os sotaques indianos a meio e os sotaques chinês e nigeriano no fim. Quando os investigadores repetiram as experiências com entrevistas, desta vez com 52 participantes dos cinco países, as diferenças foram maiores do que as observadas com vozes artificiais.
A conclusão mais preocupante dizia respeito ao conteúdo. Alguns participantes obtiveram pontuações mais baixas pela substância de uma resposta, mesmo quando leram exatamente as mesmas palavras e os modelos foram instruídos a avaliar apenas o conteúdo. O sotaque influenciava uma avaliação que deveria centrar-se nas ideias.
Orevaoghene Ahia, doutorando na Paul G. Allen School of Computer Science & Engineering da universidade e coautor principal do estudo, descreveu o padrão observado nas explicações dos modelos:
Compreendiam os participantes, mas tinham esta noção implícita de uma hierarquia entre eles, baseada no sotaque.
Como os investigadores mantiveram as palavras iguais
A equipa usou vozes geradas pela ElevenLabs para ler guiões idênticos em cinco sotaques de inglês, com vozes masculinas e femininas. Manter o texto igual permitiu aos investigadores analisar se uma alteração no som influenciava a avaliação.
Os guiões incluíam respostas a entrevistas, uma apresentação numa aula, uma apresentação numa conferência e respostas para um teste de proficiência em inglês. Cada um dos quatro modelos atribuiu pontuações separadas à forma de apresentação e ao conteúdo, numa escala de 1 a 7, e explicou sucintamente as suas decisões.
A forma de apresentação diz respeito à maneira como uma pessoa fala, incluindo a pronúncia e a clareza. O conteúdo diz respeito à própria resposta, como as ideias e a sua pertinência. Separar as duas dimensões ajudou os investigadores a perceber se os juízos sobre a voz influenciavam também os juízos sobre a mensagem.
Os cinco sotaques foram escolhidos em regiões com grandes populações anglófonas e onde os investigadores tinham contactos. Assim, o estudo comparou um conjunto específico de sotaques, e não todas as variedades de inglês faladas em todo o mundo.
Yulia Tsvetkov, professora associada na Allen School e autora sénior do estudo, explicou por que motivo a equipa escolheu modelos generalistas de referência:
Queríamos testar estes modelos de última geração porque são estes que as empresas implementariam em situações reais.
As vozes humanas revelaram diferenças maiores
Os investigadores testaram depois respostas a entrevistas de 52 pessoas dos mesmos cinco países. Cada participante leu quatro respostas preparadas e respondeu também a perguntas sem guião.
O exercício com guião permitiu outra comparação em que os participantes disseram as mesmas palavras. As respostas sem guião alargaram os testes a discursos formulados pelos próprios participantes, mais próximos do que acontece numa entrevista.
Nas gravações humanas, as diferenças entre sotaques originaram discrepâncias maiores nas pontuações do que nas vozes geradas. Esta validação com pessoas foi uma parte importante do estudo: o padrão também surgiu para além da fala artificial usada na experiência controlada de maior dimensão.
Os resultados descrevem a classificação e o sentido das diferenças, mas as descrições públicas não indicam as pontuações médias exatas nem as diferenças numéricas para cada modelo e sotaque. É possível perceber que grupos tendiam a obter notas mais baixas, mas a dimensão da penalização típica não é especificada.
A importância de uma transcrição precisa
Os modelos justificaram frequentemente as pontuações mais baixas atribuídas aos sotaques chinês e nigeriano, afirmando que a fala era pouco clara ou difícil de compreender. No entanto, os investigadores concluíram que os sistemas eram muito bons a converter essas gravações em texto escrito com precisão.
Ahia descreveu a discrepância entre as críticas dos modelos e o seu desempenho na transcrição:
Apesar de afirmarem repetidamente que os falantes chineses e nigerianos “murmuravam” ou eram “difíceis de compreender”, os modelos transcreviam muito bem a fala com sotaque.
Transcrever consiste em escrever as palavras que alguém diz. Quando um sistema regista uma resposta com precisão, mas a critica por ser difícil de compreender, a explicação merece ser analisada com cuidado. Neste caso, os investigadores relacionaram essa discrepância com a aparente preferência dos modelos por determinados sotaques.
As pontuações de conteúdo tornaram o problema mais grave. Um participante podia perder pontos duas vezes: primeiro pela forma de apresentação e depois pela qualidade de uma resposta cujo texto não tinha mudado. Numa entrevista, isso poderia fazer uma resposta idêntica parecer mais fraca simplesmente por causa da voz de quem a proferiu.
Uma preferência associada ao inglês americano
A equipa analisou também características acústicas, ou seja, propriedades mensuráveis dos sons da fala. Os investigadores calcularam a «distância acústica» de cada sotaque em relação ao inglês americano, medindo as diferenças entre os respetivos padrões sonoros.
Nesta comparação, os sotaques chinês e nigeriano eram os mais distantes da referência americana. Os sotaques britânico e indiano eram mais próximos. As pontuações tendiam a diminuir à medida que aumentava a distância medida, o que associava o padrão das avaliações às diferenças sonoras.
Os investigadores propuseram várias explicações possíveis. Os materiais de treino podem descrever alguns sotaques como difíceis de compreender, incluir poucos exemplos de determinados falantes ou valorizar expectativas familiares sobre a forma como um profissional deve falar.
Estas explicações são possibilidades avançadas pela equipa. A preocupação prática é concreta: um modelo treinado com exemplos pouco representativos pode reproduzir essas preferências numa avaliação, mesmo quando as instruções lhe pedem que avalie a resposta de forma justa.
Na Nigéria, o inglês é língua oficial, e é utilizado no ensino nas escolas indianas. Ainda assim, no estudo, os falantes de ambos os países receberam avaliações inferiores às dos falantes americanos e britânicos. O uso prolongado do inglês num país não se traduziu num tratamento igual por parte destes modelos.
O que foi testado e o que está em causa
As experiências avaliaram modelos generalistas de IA, e não os produtos de avaliação efetivamente utilizados por plataformas de recrutamento ou entidades que realizam testes de inglês. As empresas podem criar aplicações com estes modelos, mas os sistemas de avaliação comerciais têm as suas próprias conceções e procedimentos.
Para quem se candidata a um emprego, a preocupação é que o processo de avaliação penalize tanto a forma como o conteúdo de uma resposta. Para os estudantes, um problema semelhante pode afetar apresentações orais ou exames. A investigação chama a atenção para a forma como estes juízos são feitos antes de ajudarem a determinar as oportunidades de uma pessoa.
Os testes de inglês também são realizados em grande escala. Segundo números citados no artigo, o PTE Academic da Pearson, que usa IA para avaliar algumas respostas orais e é utilizado para vistos e processos de imigração, foi realizado cerca de 1,2 milhões de vezes em 2023.
O PTE Academic não foi incluído nos produtos analisados. Os investigadores usaram antes esse exemplo para ilustrar o alcance da avaliação automatizada da fala. Os autores do artigo disseram desconhecer auditorias públicas a testes de inglês avaliados por IA, enquanto o funcionamento interno dos sistemas comerciais geralmente não é divulgado.
A Google e a OpenAI financiaram parcialmente a investigação através de donativos, apesar de os seus modelos estarem entre os testados. Esta relação de financiamento faz parte do contexto de um estudo que analisa sistemas dessas empresas.
Calendário de publicação do estudo
A investigação foi publicada com o título «The Cost of Sounding Different: Accent Bias in Audio Language Models». O DOI indicado é 10.18653/2026.emnlp-main.1612, e o estudo integra as atas da Conferência de 2026 sobre Métodos Empíricos em Processamento de Linguagem Natural.
As datas situam a apresentação na conferência antes do anúncio mais amplo, em novembro:
- 25 de outubro de 2026: A equipa apresentou a investigação na EMNLP, em Budapeste, na Hungria.
- 5 de novembro de 2026: Os resultados foram anunciados publicamente, em comunicações que descreviam os cinco grupos de sotaques, os quatro modelos e a validação com 52 participantes humanos.
As duas fases de testes são fundamentais para os resultados. As vozes geradas permitiram aos investigadores manter o texto igual em muitos exemplos. As gravações humanas revelaram depois a mesma preferência geral, com diferenças maiores entre sotaques.
O que os investigadores querem que os programadores alterem
Tsvetkov defendeu a utilização de dados de treino e avaliação que representem melhor as pessoas que irão usar sistemas de fala. A equipa apelou também à divulgação de resultados relativos a diferentes populações e dialetos, em vez de recorrer apenas a uma pontuação média global.
Uma média combina os resultados de todos num só número. Se um sistema funcionar bem para um grupo numeroso e mal para um grupo mais pequeno, esse valor combinado pode ocultar a experiência do grupo minoritário.
Tsvetkov recorreu a uma comparação hipotética para explicar a preocupação:
Não queremos que a precisão média para a população em geral seja de 97%, mas que, para um grupo mais pequeno, seja de apenas 20%.
Os investigadores planeiam estudar mais sotaques humanos, incluindo variações regionais dentro dos países. Pretendem também investigar aplicações de áudio na medicina, incluindo sistemas automatizados de resposta a emergências, em que a forma como um sistema processa a fala de quem liga pode ter consequências imediatas.
Para o recrutamento e a avaliação de inglês, a recomendação é testar diretamente a equidade entre sotaques. As avaliações devem verificar se as pessoas são tratadas de forma comparável, se os juízos sobre o conteúdo se mantêm centrados no conteúdo e se as justificações apresentadas pelo sistema correspondem à sua capacidade de compreender a gravação.
Principais conclusões
- Quatro modelos de IA classificaram, em geral, os sotaques americano e britânico no topo, o indiano a meio e os sotaques chinês e nigeriano no fim.
- Algumas pontuações de conteúdo mudaram mesmo quando os participantes disseram palavras idênticas.
- Os testes com 52 participantes humanos revelaram diferenças maiores entre sotaques do que os testes com vozes geradas.
- Os modelos transcreveram com precisão uma fala que, por vezes, descreviam como pouco clara.
- O estudo analisou modelos generalistas, e não produtos comerciais de recrutamento ou de avaliação de inglês.
- Os investigadores apelaram à publicação de avaliações que abranjam diferentes sotaques e planeiam aprofundar o estudo da fala regional e do áudio médico.