111 contribuições privadas expõem uma lacuna nas ambições de Taiwan em matéria de IA
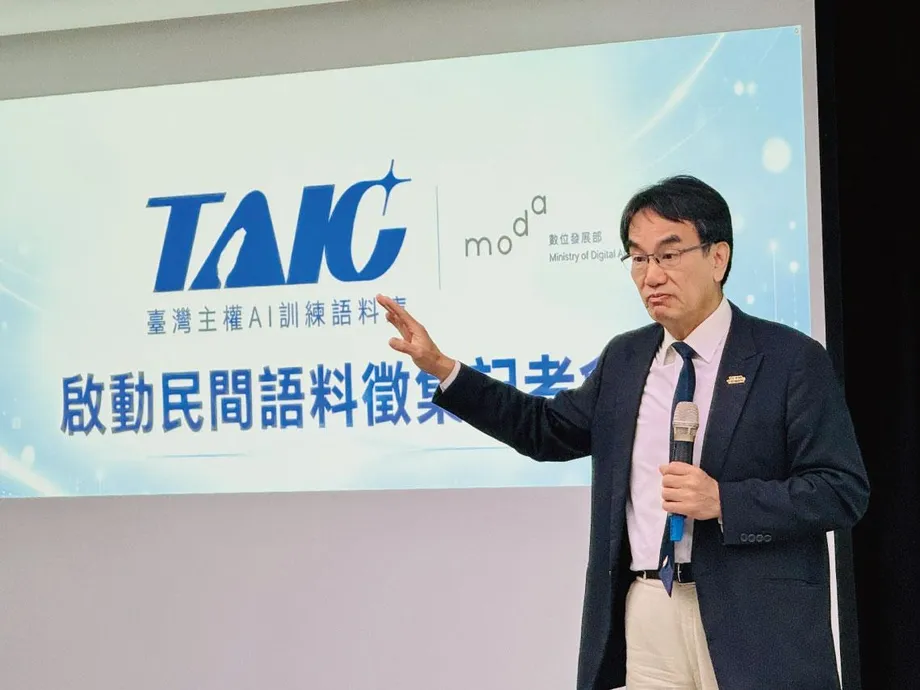
A colecção de dados do Governo de Taiwan para treinar sistemas de IA reúne 7 161 entradas, mas apenas 111 foram fornecidas por privados. Isso representa cerca de 1,6% do total, uma proporção reduzida para um projecto que pretende ajudar a inteligência artificial a compreender a língua, a cultura e o quotidiano de Taiwan.
Índice
- 111 contribuições privadas expõem uma lacuna nas ambições de Taiwan em matéria de IA
- O que contém a colecção do Governo
- A importância da língua local
- Uma queixa-crime alterou os cálculos
- O papel dos direitos de autor no treino de IA
- Autorização voluntária, sem transferência da titularidade
- Já existe um pequeno precedente de colaboração remunerada
- Excepções legais e licenças colectivas são opções concorrentes
- O TAIDE mostra por que razão o acesso e os recursos são importantes
- Principais pontos
O Ministério dos Assuntos Digitais lançou o Corpus de Treino de IA Soberana de Taiwan a 24 de Dezembro de 2025. Mais de 200 organismos públicos contribuíram com mais de 2 000 conjuntos de dados, contendo 600 milhões de tokens. Os tokens são pequenas unidades de texto processadas pelos sistemas de IA: por vezes, um carácter; outras, parte de uma palavra.
A participação do sector público ajudou a alcançar esta escala. Atrair editoras, autores, plataformas educativas e organizações noticiosas é mais difícil: os programadores precisam de autorização para copiar textos valiosos para o treino, enquanto os detentores dos conteúdos querem receber uma compensação e controlar a utilização das suas obras.
Numa audição parlamentar a 14 de Outubro de 2026, o ministro dos Assuntos Digitais, Lin Yi-jing, afirmou que a participação privada era voluntária e que o Governo pretendia que as principais empresas de IA, sobretudo as norte-americanas, pagassem pelos conteúdos usados no treino. Os conteúdos noticiosos não estão abrangidos pelo actual programa de recolha de conteúdos privados.
O que está em causa vai além da dimensão de uma base de dados. Um modelo treinado com textos de Taiwan pode aprender vocabulário local, explicar tradições culturais e responder a perguntas tendo em conta as instituições do território. Mas os autores e as organizações que produzem esses conteúdos também dependem do seu valor comercial. Taiwan procura alargar o acesso às suas obras enquanto decide quem deve pagar, o que abrange a autorização e que aspectos das regras de direitos de autor precisam de ser clarificados.
O que contém a colecção do Governo
O comunicado de lançamento de Dezembro do ministério descreve uma colecção sobre língua, cultura, educação, biologia e geografia. Reúne dados abertos do Governo publicados ao longo de mais de dez anos e permite aos utilizadores pesquisar e descarregar materiais.
O Ministério da Cultura forneceu conjuntos de dados sobre arte pública e património cultural. O Ministério da Educação contribuiu com dados de dicionários de taiwanês, hacá e mandarim. Estes recursos dão aos programadores material sobre significados e usos locais, além de informação sobre lugares, objectos e tradições.
A descrição do programa do corpus do ministério também identifica o Conselho dos Povos Indígenas e o Conselho dos Assuntos Hacá como organismos participantes. Entre os temas previstos estão a história, o património cultural, o turismo e a cultura local. O ministério afirma que os textos de treino úteis devem ser coerentes, completos e fluentes.
Os números apresentados aos deputados em Setembro de 2026 apontavam para mais de 5 000 conjuntos de dados e mais de 2,4 mil milhões de tokens. Face aos 600 milhões de tokens anunciados no lançamento, isso representa mais de quatro vezes mais texto, medido em tokens. As 7 161 entradas e as 111 contribuições privadas dão outra perspectiva sobre a composição da colecção.
A importância da língua local
Wu Che-yu, artista de novos media e fundador do projecto comunitário de conhecimento Taiwan.md, defende que a escrita em chinês tradicional ocupa pouco espaço no treino dos principais sistemas de IA. Estima que represente menos de 1% dos materiais de treino em chinês, um valor que cita para explicar o seu projecto.
A preocupação de Wu vai além da conversão de caracteres simplificados em caracteres tradicionais. Taiwan e a China usam palavras diferentes para algumas coisas do quotidiano, e uma mesma expressão pode ter significados distintos. O conhecimento local também abrange instituições, história e gastronomia, incluindo pratos que recebem menos atenção internacional do que o chá de pérolas ou os raviolis de sopa.
O Taiwan.md utiliza ferramentas de IA para recolher informação na Internet e editar artigos sobre a natureza, a sociedade e a história de Taiwan. Os seus 1 123 artigos baseiam-se em artigos académicos, blogues e informação governamental acessíveis ao público. Wu quer que modelos generalistas como o ChatGPT, o Gemini e o Claude encontrem mais textos que reflictam a experiência taiwanesa.
O Governo descreve esta ambição como IA soberana: desenvolver recursos e capacidades de IA que Taiwan possa orientar de acordo com as suas próprias necessidades. O corpus fornece material de treino; projectos como o Taiwan.md procuram facilitar aos programadores de IA o acesso ao conhecimento local.
Uma queixa-crime alterou os cálculos
Em Julho de 2025, um doutorando da Universidade Nacional de Taiwan foi alvo de uma queixa-crime por violação de direitos de autor, depois de distribuir um corpus em chinês tradicional com 140 000 artigos não autorizados da Agência Central de Notícias. O estudante tinha recolhido os materiais num sítio norte-americano que alojava recursos abertos e partilhou a colecção sem cobrar.
As partes chegaram posteriormente a acordo. O estudante pediu desculpa, apelou aos investigadores para verificarem a legalidade das fontes de dados que utilizam e retirou todo o corpus.
Wu afirma que o caso tornou os programadores independentes mais cautelosos. A equipa do Taiwan.md descarta materiais quando detecta um possível problema de direitos de autor, o que abranda o crescimento da colecção. Para um projecto pequeno, a possibilidade de um processo criminal acrescenta um risco pessoal a uma tarefa de verificação de autorizações que já é difícil.
Várias datas ajudam a perceber a evolução da questão:
- Início de 2023: O Conselho Nacional da Ciência e da Tecnologia iniciou o projecto TAIDE, um modelo linguístico, com um financiamento superior a 200 milhões de dólares taiwaneses (NT$).
- Julho de 2025: O doutorando foi alvo de uma queixa relacionada com o corpus que continha artigos noticiosos não autorizados.
- 24 de Dezembro de 2025: O Ministério dos Assuntos Digitais anunciou o seu corpus de IA soberana, com 600 milhões de tokens.
- Setembro de 2026: Os dados do ministério apontavam para mais de 5 000 conjuntos de dados e mais de 2,4 mil milhões de tokens.
- 14 de Outubro de 2026: O ministro Lin disse aos deputados que as contribuições privadas eram voluntárias e que a celebração de acordos remunerados para utilização de conteúdos era um objectivo político.
O papel dos direitos de autor no treino de IA
Chen Chi-tung, advogado sénior do escritório de advogados Luguo, identifica a cópia como uma questão jurídica central. Em geral, os programadores têm de reproduzir os textos antes de os utilizarem para treinar um modelo. A lei dos direitos de autor confere aos titulares o controlo da reprodução, sem prejuízo de excepções como a utilização legítima.
A utilização legítima permite, em determinadas circunstâncias, usar obras protegidas sem autorização. Chen afirma que as disposições actualmente em vigor em Taiwan não contemplam expressamente o treino de IA, deixando os programadores sem saber se um tribunal aceitaria essa utilização.
O treino e a geração de respostas também são actos distintos. Durante o treino, um sistema processa exemplos para aprender padrões. Na fase de geração, produz texto para um utilizador. Chen propõe que a legislação trate separadamente estas duas fases, incluindo o risco de as respostas reproduzirem de perto obras protegidas.
O Instituto da Propriedade Intelectual, tutelado pelo Ministério dos Assuntos Económicos, afirma que eventuais alterações à lei continuam em análise. O Ministério dos Assuntos Digitais identifica aquele instituto como responsável pela política de direitos de autor. Uma investigação do Yuan de Controlo também recomendou que se trabalhasse activamente na adaptação do enquadramento jurídico, depois de o Yuan Executivo ter atribuído essa tarefa ao instituto.
Autorização voluntária, sem transferência da titularidade
O ministro Lin disse à Comissão dos Transportes do Yuan Legislativo que o programa de recolha de conteúdos privados começa pelas editoras e pelas plataformas de livros electrónicos. Indicou quatro tipos de materiais procurados:
- Livros cuja protecção por direitos de autor já expirou.
- Descrições de livros fornecidas pelas editoras.
- Excerto seleccionados de livros disponibilizados para consulta prévia.
- Obras licenciadas voluntariamente por autores individuais.
Lin afirmou que o ministério pretendia obter autorização para usar as obras no treino de IA, mantendo os autores a titularidade dos direitos de autor. Uma licença permite que outra parte realize determinadas actividades, nos termos acordados. O seu âmbito pode abranger aspectos como as utilizações permitidas e a duração.
A deputada do Partido Democrático Progressista Lin Chu-yin questionou como seriam pagos os contribuidores, o que aconteceria se retirassem posteriormente a autorização e de que forma seriam protegidos os seus interesses caso o treino conduzisse à criação de outros produtos. Hung Yu-hsiang, deputado do Partido Popular de Taiwan, propôs um serviço que assegurasse o controlo de qualidade, a regularização dos direitos, a aquisição remunerada e a gestão das diferentes categorias de licenças.
O ministério publicou a Licença do Corpus de Treino de IA Soberana de Taiwan, Versão 1, e trabalhou com o Instituto da Propriedade Intelectual em exemplos para ajudar os organismos públicos a aplicá-la. A normalização das condições pretende reduzir negociações repetidas e disputas sobre direitos de autor. O ministério também está a planear incentivos às contribuições. As propostas divulgadas publicamente ainda não definem os valores dos pagamentos, as condições para retirar a autorização nem as regras aplicáveis aos produtos resultantes.
Já existe um pequeno precedente de colaboração remunerada
Lee Po-feng, presidente da Open Culture Foundation, afirma que é pouco provável que as editoras participem em grande número se lhes for pedido que forneçam gratuitamente materiais valiosos. Aponta para um pequeno projecto de treino que conseguiu a colaboração de plataformas de comunicação social e de educação através de um acordo negociado.
As condições incluíam um pagamento único pela licença, um limite de dois anos para a utilização dos dados e acesso prioritário ao modelo resultante para os fornecedores de conteúdos participantes. O acordo ofereceu aos contribuidores uma compensação financeira, um período de utilização definido e algo útil em troca.
Wang Rong-wen, presidente da Yuan-Liou Publishing, também defende que os programadores do sector público e do sector comercial devem prever nos seus orçamentos verbas para licenças de conteúdos. Considera que o receio de queixas-crime condiciona tanto os programadores privados como os responsáveis públicos que procuram apoiar projectos de IA.
Lin disse aos deputados que o objectivo final do Governo era cobrar às grandes empresas de IA pelo acesso aos conteúdos. Afirmou que as disputas sobre direitos de autor relacionadas com novas tecnologias podem durar entre três e cinco anos, pelo que o ministério começaria por materiais que suscitam menos litígios. O prazo referido dizia respeito à duração provável da controvérsia, não a uma data-limite para a aprovação de legislação ou para a criação de um regime de pagamentos.
Excepções legais e licenças colectivas são opções concorrentes
Chen propõe a criação de um capítulo específico para a IA na Lei dos Direitos de Autor de Taiwan. Esse capítulo estabeleceria uma excepção para a prospecção de texto e dados, exigiria a divulgação das fontes de treino e reduziria o risco de processos criminais para as actividades que cumprissem os requisitos.
A prospecção de texto e dados consiste em utilizar software para analisar grandes quantidades de material e identificar padrões. A União Europeia, o Japão e Singapura têm excepções para determinadas formas desta actividade, embora as regras e condições sejam diferentes. Chen considera que essas abordagens podem servir de referência para o debate em Taiwan.
Lee propõe uma medida administrativa mais imediata: orientações que expliquem que utilizações de conteúdos para treino são consideradas legítimas pelas autoridades e quais podem constituir infracção. Como exemplo, aponta a lista de verificação e as orientações sobre direitos de autor e IA, publicadas em 2024 pela Agência para os Assuntos Culturais do Japão, que tornam as expectativas mais claras para programadores e criadores.
Chen sugere também o licenciamento colectivo, inspirado na Sociedade de Direitos de Autor de Música de Taipei, conhecida pela sigla MÜST. Neste modelo, uma organização gere as autorizações de vários titulares de direitos, cobra taxas e distribui os pagamentos. Um serviço semelhante para a IA poderia reduzir o trabalho de negociar separadamente com centenas de editoras ou autores.
Chang Chung-hsin, professor auxiliar convidado no Instituto de Propriedade Intelectual da Universidade Nacional de Tecnologia de Taipei, defende uma abordagem diferente. Considera que os programadores devem pagar ao abrigo das regras de direitos de autor em vigor, em vez de procurarem alterações à lei. A sua posição coloca o acesso negociado a conteúdos valiosos de editoras e meios de comunicação social no centro da solução.
O TAIDE mostra por que razão o acesso e os recursos são importantes
O anterior Motor Fiável de Diálogo por IA de Taiwan, ou TAIDE, ilustra a dependência de um modelo em relação a algumas colecções acessíveis. Criado no início de 2023 como um projecto do Conselho Nacional da Ciência e da Tecnologia, recebeu um financiamento inicial superior a 200 milhões de dólares taiwaneses (NT$).
O TAIDE utilizou materiais de treino provenientes de 15 organismos públicos. Cerca de quatro milhões de artigos da Agência Central de Notícias representavam 70% dos seus dados textuais. Os materiais foram obtidos tendo em conta as questões de direitos de autor, mostrando como o acesso organizado a arquivos noticiosos de grande dimensão pode apoiar um modelo local.
O investigador principal, Yuh-Jye Lee, do Centro de Segurança da Informação de Taiwan, na Academia Sinica, explicou a importância de dispor de uma alternativa nacional:
No início, provavelmente não conseguiremos igualar os grandes modelos, mas termos o nosso próprio motor de diálogo significa que, pelo menos, temos uma escolha.
O primeiro modelo foi desenvolvido com base no Llama 2, da Meta, e tinha sete mil milhões de parâmetros, os valores numéricos que um modelo ajusta durante a aprendizagem. O Centro Nacional de Computação de Alto Desempenho dispunha de 1 028 processadores gráficos V100 e adquiriu nove processadores H100 em Novembro de 2023 para o projecto, mantendo os serviços habituais.
Mais tarde, o projecto de resposta a perguntas agrícolas Demeter GPT, da Universidade Nacional Chung Hsing, passou do ChatGPT para o TAIDE. O professor associado Fan Yao-chung referiu que a precisão das respostas em chinês melhorou depois de treino adicional. O laboratório pagava anteriormente à OpenAI entre NT$ 1 e NT$ 2 por resposta; ao executar o TAIDE localmente, passou a suportar as despesas de funcionamento dos seus próprios computadores e da electricidade.
A iniciativa do corpus de Taiwan procura resolver a questão do fornecimento de textos que sustenta estas aplicações. Os dicionários e os registos culturais do Governo constituem uma base. Um acesso mais amplo a publicações, materiais especializados de ensino e jornalismo dependerá de acordos que os programadores possam suportar e que os detentores dos conteúdos estejam dispostos a aceitar.
Principais pontos
- Os contribuidores privados forneceram 111 das 7 161 entradas do corpus, cerca de 1,6%.
- O Governo anunciou 600 milhões de tokens no lançamento, em Dezembro de 2025; em Setembro de 2026, o total ultrapassava os 2,4 mil milhões.
- O ministro Lin afirma que a participação privada é voluntária e que os autores mantêm a titularidade dos direitos de autor.
- Os conteúdos noticiosos estão excluídos do actual programa de recolha de conteúdos privados, enquanto o ministério procura acordos remunerados com empresas de IA.
- Uma queixa-crime apresentada em Julho de 2025 por causa de 140 000 artigos noticiosos não autorizados aumentou a preocupação entre os programadores independentes.
- Entre as propostas estão orientações mais claras sobre utilização legítima, uma excepção para a prospecção de dados, licenças colectivas e pagamentos directos ao abrigo da lei em vigor.