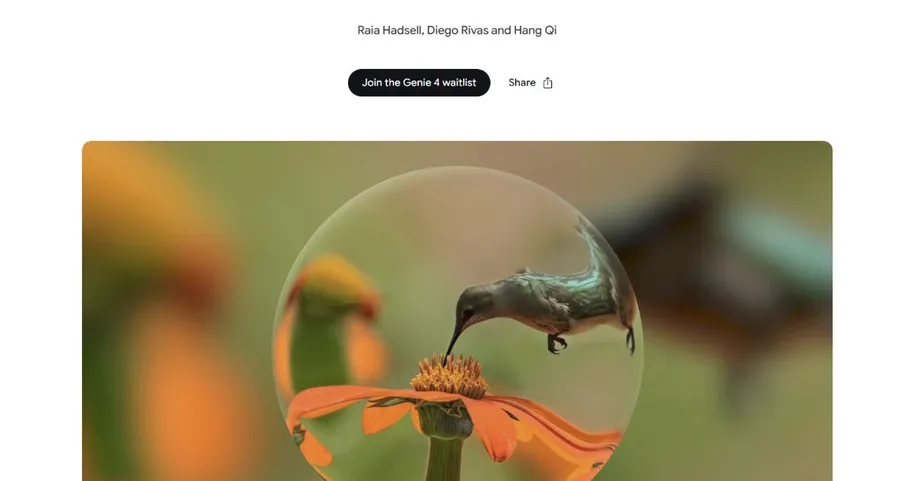
Mundos virtuais que respondem com imagens, movimento e som
A Google DeepMind apresentou o Genie 4, um modelo experimental de inteligência artificial que gera mundos virtuais interativos com som, diálogo falado e ambientes físicos em mudança. Anunciado a 27 de outubro, hora dos EUA, o modelo está inicialmente disponível para um pequeno grupo de utilizadores de confiança, estando previsto o acesso através do Project Genie, da Gemini API e do Google AI Studio.
Índice
- Mundos virtuais que respondem com imagens, movimento e som
- Em que difere um mundo interativo de um vídeo gerado
- O áudio integra as personagens na interação
- O Gemini planeia enquanto o Genie gera
- Porque quer a Google que os robôs treinem neste ambiente
- O planeamento de filmes oferece uma aplicação mais imediata
- Dois minutos de consistência continuam a ser um limite apertado
- Quem terá acesso e quanto custará?
- Do Genie 3 à concorrência mais alargada na simulação
- Principais pontos
A Google afirma que o Genie 4 consegue manter uma cena consistente durante até dois minutos, o dobro do cerca de um minuto atribuído ao seu antecessor, o Genie 3. Durante esse período, os utilizadores podem percorrer um ambiente, mudar o estado do tempo, introduzir pessoas ou objetos e ouvir as personagens reagir ao que está a acontecer.
Sundar Pichai, presidente executivo da Alphabet e da Google, descreveu o modelo ao anunciar a pré-visualização de investigação:
o nosso modelo de mundos mais realista e interativo
A principal novidade é o áudio nativo, ou seja, o som é gerado como parte da experiência simulada, em vez de ser acrescentado posteriormente. O vento, as ondas, a música de fundo e as conversas podem acompanhar a transformação de um mundo. A Google afirma também que melhorou o movimento humano e a simulação de efeitos físicos, como as colisões e a aerodinâmica, isto é, a forma como o ar afeta os objetos em movimento.
A Google está a posicionar esta tecnologia para o planeamento de filmes, o desenvolvimento de jogos, a educação e o treino de robôs ou agentes de IA antes de estes operarem em ambientes reais. As limitações imediatas são igualmente concretas: as cenas duram pouco tempo, os objetos podem mudar de forma inesperada, pode ser difícil ler o texto dentro de uma cena e a precisão do áudio continua por resolver.
Em que difere um mundo interativo de um vídeo gerado
O Genie parte de uma descrição textual ou de uma imagem e gera um ambiente que os utilizadores podem explorar. Um vídeo gerado convencional segue uma sequência que os espectadores veem. Um modelo de mundos continua a gerar o que acontece a seguir em resposta às ações dos utilizadores.
Os controlos do teclado permitem aos utilizadores deslocarem-se e posicionarem a câmara. As instruções escritas podem alterar o ambiente enquanto este está em funcionamento, por exemplo, mudando o estado do tempo, acrescentando uma personagem ou alterando o ponto de vista. O sistema tem então de criar as imagens seguintes para refletir essas mudanças.
A Google descreve o processo como a geração da experiência fotograma a fotograma. Em vez de exigir que todas as interações possíveis sejam preparadas antecipadamente, o modelo prevê como a cena deve prosseguir quando alguém age dentro dela.
Isso torna a continuidade um desafio central. Uma simulação útil tem de se lembrar da localização dos objetos, da forma como as pessoas se estão a mover e do que já aconteceu. Uma cena que parece convincente por um momento torna-se menos útil se a disposição mudar quando o utilizador se vira.
O áudio integra as personagens na interação
O Genie 4 acrescenta sons ambientais, música e fala a esse mundo visual em transformação. A Google afirma que o áudio pode corresponder ao local gerado, incluindo o vento a soprar entre as árvores ou as ondas a rebentar na costa.
As personagens também podem falar em resposta às instruções dos utilizadores e aos acontecimentos dentro da simulação. Pretende-se que o diálogo mude consoante a situação, em vez de seguir uma banda sonora fixa. Os utilizadores podem especificar elementos áudio nos seus comandos, além dos visuais.
A Google afirma que as figuras humanas também melhoraram noutros aspetos, com movimentos mais naturais e reações ao que as rodeia. As suas ações podem ser dirigidas enquanto a simulação continua, reunindo o comportamento das personagens e a edição da cena na mesma interação.
A precisão do áudio continua a ser um problema de desenvolvimento reconhecido pela equipa. Para quem planeia uma cena ou um exercício interativo, o requisito prático é que a fala e os sons ambientais continuem adequados à medida que a ação muda.
O Gemini planeia enquanto o Genie gera
A Google integrou mais estreitamente a família de modelos de IA Gemini no Genie 4. Os modelos têm funções diferentes: o Genie gera o mundo simulado, enquanto o Gemini ajuda a orientar o que acontece e verifica se o resultado corresponde ao plano pretendido.
O Gemini Omni dá suporte à aparência e ao comportamento do ambiente. O Gemini 3.8 Flash acompanha os fotogramas recebidos, divide os objetivos em etapas mais pequenas, verifica se as ações são bem-sucedidas e ajusta o plano quando a cena muda ou um utilizador intervém.
Em termos simples, uma parte do sistema cria a vista seguinte, enquanto outra acompanha o progresso em direção a um objetivo. Pretende-se que esta organização ajude os acontecimentos a desenrolarem-se numa sequência lógica, sobretudo quando uma tarefa exige várias ações em vez de uma única resposta imediata.
Tejas Kulkarni, diretor de investigação na Google, descreveu a visão da empresa a longo prazo durante uma sessão informativa:
O que veremos cada vez mais no futuro são estes modelos de mundos híbridos, em que se combinam o Gemini a escrever código e texto e o Genie a processar isso em tempo real e a simular a realidade a diferentes níveis de abstração,
A combinação proposta permitiria que a linguagem, o código e a simulação visual funcionassem em conjunto. O Genie 4 já aplica, de forma limitada, esta divisão de responsabilidades, com o Gemini a ajudar a orientar um mundo que é gerado à medida que o utilizador o explora.
Porque quer a Google que os robôs treinem neste ambiente
A Google DeepMind está a testar de que forma o Genie 4 poderá fornecer ambientes de treino para robôs e agentes de IA. Um agente é um programa que procura atingir um objetivo escolhendo ações, avaliando os resultados e decidindo o que fazer a seguir.
Num experimento relacionado com o Gemini Robotics, o Gemini 4 Argon dividiu tarefas em etapas que o Genie 4 simulou em tempo real. O objetivo é explorar a forma como um robô poderia realizar uma tarefa complexa antes de a tentar executar no mundo físico.
A Google afirma que os ambientes virtuais podem recriar situações difíceis de encontrar ou de preparar na realidade. Os programadores poderiam alterar as condições e analisar a resposta de um agente, sem terem de reconstruir um espaço físico de testes para cada variação.
As melhorias anunciadas nas colisões e na aerodinâmica são particularmente relevantes para esta utilização. O treino precisa de uma relação útil entre uma ação e o seu resultado: por exemplo, a forma como um objeto se move após o contacto ou como um ambiente reage ao movimento. A Google reconhece que as interações físicas complexas continuam a ser um desafio para o modelo.
O planeamento de filmes oferece uma aplicação mais imediata
Os utilizadores de confiança identificaram a prototipagem de filmes e a criação rápida de storyboards como possíveis aplicações. Um storyboard organiza uma sequência de planos antes das filmagens. O Genie 4 poderia permitir a uma equipa criativa explorar posições de câmara, ações das personagens e mudanças de ambiente enquanto uma ideia ainda está a tomar forma.
Diego Rivas, engenheiro da Google DeepMind, explicou durante uma sessão informativa para a imprensa por que razão as respostas imediatas podem ser úteis nesta fase:
O aspeto em tempo real torna-se mais valioso nas áreas em que manter um estado de fluxo no processo criativo é extremamente útil,
Rivas apontou a criação de ideias e os storyboards como exemplos. A vantagem prática é a rapidez: quem cria poderia alterar uma cena e explorar o resultado sem parar para preparar uma sequência separada para cada variação.
A Google disponibiliza também o Veo, que gera clips de vídeo com áudio sincronizado a partir de comandos. Rivas falou na possibilidade futura de o Gemini Omni ajudar a transformar protótipos em recursos criativos, mas afirmou que essas capacidades ainda estão longe de estar disponíveis.
Os jogos e a educação interativa são outras utilizações propostas. O elemento comum é uma cena que reage ao participante, em vez de uma obra audiovisual acabada que se reproduz sempre da mesma forma.
Dois minutos de consistência continuam a ser um limite apertado
O período de consistência anunciado para o Genie 4, de dois minutos, duplica o limite de cerca de um minuto do Genie 3. Isso dá aos utilizadores mais margem para explorar uma ideia, mas continua a restringir a duração de uma atividade contínua.
A Google afirma que os objetos e os pormenores visuais podem variar à medida que a simulação decorre. Um objeto pode mudar de aparência ou de posição, e o sistema pode perder a noção de como a cena começou. Por isso, as sessões mais longas continuam a ser difíceis, mesmo com o Gemini a ajudar a manter a continuidade.
O texto gerado dentro de um mundo também pode ser ilegível. Isso cria um problema concreto para cenas com sinais, instruções ou outros textos que uma pessoa precisa de ler.
A Google descreve o Genie 4 como um modelo experimental numa fase inicial e está a trabalhar com utilizadores de diferentes áreas. Rivas afirmou que a experiência final do produto ainda está a ser definida. Por agora, a experiência útil centra-se em experiências de curta duração, sendo ainda necessário trabalhar a continuidade visual, o comportamento físico e o som.
Quem terá acesso e quanto custará?
A pré-visualização de investigação do Genie 4 começou com utilizadores de confiança. A Google planeia alargar o acesso dos consumidores através do Project Genie, para subscritores do Google AI Ultra, e o acesso dos programadores através de parcerias de acesso antecipado que utilizem a Gemini API e o Google AI Studio.
A Google disse que essa expansão está para breve, prevendo o início da disponibilização nas próximas semanas, mas não indicou uma data concreta. O Project Genie está a aceitar inscrições para a lista de espera. O acesso à API permitiria aos programadores ligar o modelo ao seu próprio software, enquanto o AI Studio oferece um espaço para experimentar os modelos da Google.
Os planos Google AI Ultra são anunciados a partir de 100 dólares por mês. Ainda não foram anunciados preços separados para programadores que utilizem o Genie 4. A possibilidade de acesso através do AI Pro e do AI Plus foi abordada como uma eventual expansão posterior, e não como parte confirmada do lançamento.
A Google afirma que os vídeos e áudios gerados terão o SynthID, a sua marca de água digital para identificar conteúdos produzidos por IA. A marca destina-se a ajudar a identificar o material produzido pelo sistema à medida que estas experiências simuladas chegam a mais utilizadores.
Do Genie 3 à concorrência mais alargada na simulação
O Genie 4 surge na sequência de várias etapas para tornar os modelos de mundos da Google acessíveis para além das demonstrações de investigação:
- Agosto de 2025: a Google DeepMind anunciou o Genie 3.
- Janeiro de 2026: a Google começou a testar o Project Genie com esse modelo.
- Maio de 2026: a Google anunciou a integração com o Street View.
- 27 de outubro, hora dos EUA: a Google anunciou o Genie 4 e a pré-visualização de investigação inicial.
A concorrência também está a ir além das cenas interativas sem som. O GWM Worlds 2, da Runway, lançado alguns meses antes do Genie 4, reage às ações dos utilizadores e inclui geração de áudio.
Outros movimentos do setor demonstram o interesse pela simulação, tanto para o desenvolvimento da IA como para sistemas físicos. A Rivian adquiriu a Third Dimension para integrar capacidades de simulação nos testes dos seus veículos. A aquisição anunciada pela AMD da World Labs e as negociações da Amazon para comprar a Decart também colocam a tecnologia de modelos de mundos no contexto de uma vaga mais ampla de negócios, embora as conversações da Amazon ainda não tenham resultado num acordo.
A mais recente contribuição da Google combina a geração de cenas, o diálogo e o planeamento do Gemini num único sistema experimental. O próximo passo concreto é alargar o acesso, permitindo que mais criadores e programadores descubram que tarefas curtas o modelo consegue realizar de forma fiável.
Principais pontos
- A Google DeepMind anunciou o Genie 4 a 27 de outubro, hora dos EUA, começando pelos utilizadores de confiança.
- O modelo gera mundos interativos com sons ambientais, música e diálogo falado que reage às ações.
- A Google afirma que as cenas se mantêm consistentes durante até dois minutos, o dobro do limite de cerca de um minuto do Genie 3.
- Os modelos Gemini ajudam a planear ações, acompanhar as cenas geradas e ajustar as simulações.
- As utilizações previstas incluem storyboards para filmes, jogos, educação e treino de robôs.
- Os objetos podem variar, o texto pode ser ilegível e a física complexa e a precisão do áudio continuam a ser desafios de desenvolvimento.
- Está previsto disponibilizar o acesso através do Project Genie, da Gemini API e do Google AI Studio, mas ainda não foi anunciada uma data concreta para a expansão nem um preço para programadores.