Um modelo que aprende as letras do RNA e as ligações entre elas
Investigadores da Universidade de Ciência e Tecnologia da China divulgaram o structRFM, um modelo-base aberto de RNA treinado com 21 milhões de pares de sequências de RNA e estruturas anotadas computacionalmente. A divulgação inclui os dados de treino emparelhados, os pesos do modelo e o código-fonte, disponibilizando a outros laboratórios os materiais necessários para reproduzir o trabalho e adaptar o sistema.
Índice
- Um modelo que aprende as letras do RNA e as ligações entre elas
- Porque é que a dobragem é tão importante como a sequência
- Como foram reunidos 21 milhões de pares de treino
- Ensinar o modelo com informação ocultada
- O que revelaram os testes estruturais
- Do processamento do RNA à classificação funcional
- O que a disponibilização aberta oferece aos investigadores
- A equipa e o calendário da publicação
- O que os resultados mudam na investigação do RNA
- Pontos-chave
O estudo, publicado pela Nature a 4 de novembro de 2026, descreve um modelo que aprende tanto a ordem dos blocos moleculares que constituem o RNA como as ligações que ajudam essas moléculas a dobrar-se. A sua adaptação para prever estruturas tridimensionais, denominada Zfold, obteve um desempenho que os autores descrevem como comparável ao do AlphaFold3 nas avaliações CASP15-natural, CASP16 e RNA-Puzzles.
A vantagem prática é que, após o treino, o structRFM necessita apenas de uma sequência de RNA como entrada. Produz informação que os investigadores podem utilizar em várias tarefas, incluindo a previsão da estrutura molecular, a identificação de locais envolvidos no processamento do RNA e a classificação de moléculas de RNA por função.
O artigo de investigação sobre o structRFM publicado pela Nature apresenta o trabalho como uma forma de tornar o conhecimento estrutural útil em diferentes tarefas de previsão. Peng Xiong e S. Kevin Zhou são os autores correspondentes, e Heqin Zhu é o primeiro autor.
Porque é que a dobragem é tão importante como a sequência
O RNA participa na produção de proteínas, na regulação dos genes e no processamento de mensagens genéticas. A sua sequência corresponde à ordem dos nucleótidos, as unidades moleculares habitualmente representadas pelas letras A, U, C e G. Essa ordem transporta informação, enquanto a forma como a molécula se dobra contribui para determinar o seu funcionamento.
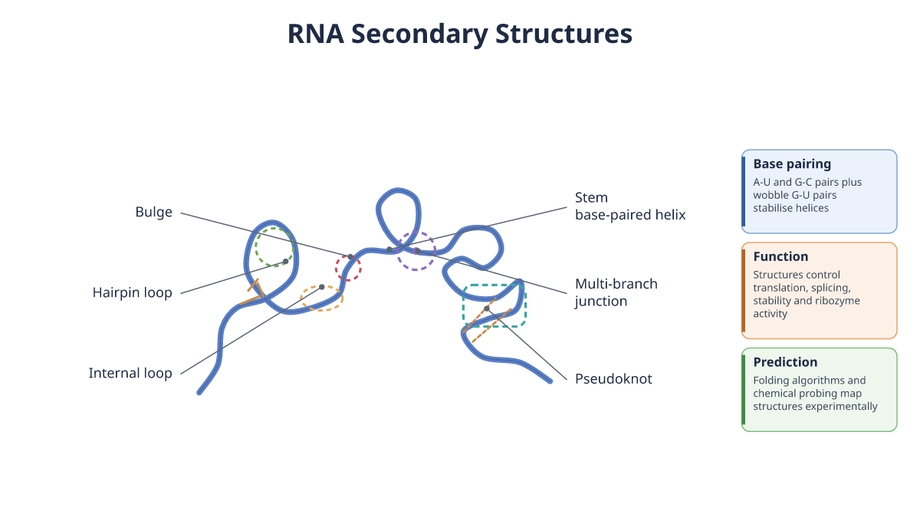
Partes de uma cadeia de RNA podem emparelhar com outras partes da mesma cadeia. Essas ligações criam uma estrutura secundária, um padrão de regiões emparelhadas, hastes e ansas. Em seguida, a molécula dobra-se numa forma tridimensional, conhecida como estrutura terciária, que afeta a sua atividade e as interações com outras moléculas.
Muitos modelos de linguagem para RNA aprendem padrões a partir de grandes coleções de sequências, tal como um modelo de linguagem aprende relações entre palavras. Durante o treino, o structRFM incorpora informação sobre os nucleótidos que emparelham entre si, ajudando-o a aprender ligações entre posições que podem estar muito distantes na sequência.
Os investigadores procuraram preservar a flexibilidade de um modelo-base: um sistema treinado de forma abrangente, cujas características aprendidas podem ser adaptadas a diferentes finalidades. O objetivo era integrar a informação sobre a dobragem nessa base partilhada, em vez de treinar um sistema útil apenas para uma tarefa estrutural.
Como foram reunidos 21 milhões de pares de treino
A equipa construiu um conjunto de dados com cerca de 21 milhões de pares de sequências de RNA e estruturas secundárias. As anotações estruturais foram geradas computacionalmente, permitindo aos investigadores treinar o modelo numa escala muito superior à de uma coleção composta apenas por estruturas determinadas em experiências laboratoriais.
As previsões computacionais podem conter erros e refletir os pontos fortes e fracos do método que as produziu. Para reduzir a dependência de um único preditor, os investigadores introduziram o MUSES, um conjunto de modelos de fontes múltiplas para estruturas secundárias. Um conjunto deste tipo combina informação proveniente de várias fontes de previsão, em vez de depender inteiramente de uma só.
O MUSES aborda um problema central do treino de modelos com estruturas previstas: os erros repetidos nas anotações de treino podem moldar aquilo que o modelo aprende. A combinação de previsões estruturais foi concebida para reduzir o enviesamento do preditor, mantendo informação útil sobre o emparelhamento de bases.
Os recursos de treino e avaliação do estudo recorrem a coleções biológicas consolidadas, incluindo RNAcentral, Rfam e Protein Data Bank. A declaração sobre os dados identifica as versões relevantes, incluindo a versão 24.0 do RNAcentral e as versões 14.10 e 15.0 do Rfam, para que os investigadores possam rastrear os conjuntos de dados utilizados nas experiências.
Ensinar o modelo com informação ocultada
O structRFM utiliza modelação de linguagem mascarada, um método de treino em que partes da entrada são ocultadas e o modelo aprende a recuperar a informação em falta a partir do contexto envolvente. No caso do RNA, isto significa aprender relações entre nucleótidos, em vez de palavras.
A equipa integrou o emparelhamento de bases neste processo através de uma operação de correspondência entre pares. Uma taxa de mascaramento dinâmica equilibra o treino orientado pelas ligações estruturais com o mascaramento de posições individuais de nucleótidos. Desta forma, o modelo pode aprender tanto padrões locais da sequência como relações associadas à dobragem.
O modelo resultante fornece três tipos de características: informação sobre a sequência no seu conjunto, informação sobre cada nucleótido e informação sobre pares de nucleótidos. Uma característica é uma representação numérica que outro sistema de previsão pode utilizar. Diferentes tarefas podem recorrer a diferentes níveis dessa representação.
Os investigadores também realizaram experiências de ablação, que removem ou alteram partes de um modelo para testar o seu contributo. Essas experiências corroboraram o contributo tanto da informação estrutural como da estratégia de mascaramento para as melhorias comunicadas, sustentando as opções de conceção do structRFM.
O que revelaram os testes estruturais
O structRFM teve um desempenho elevado na classificação de homologia sem treino específico para a tarefa. A homologia diz respeito a relações herdadas de uma origem evolutiva comum. Neste contexto, a classificação sem treino específico testa a utilidade das representações aprendidas para reconhecer essas relações sem treinar o modelo especificamente para a tarefa de classificação em causa.
Os autores comunicam também melhorias na previsão da estrutura secundária e um desempenho elevado em famílias de RNA recentemente disponibilizadas. Uma família de RNA agrupa moléculas relacionadas que partilham características de sequência ou estruturais. A avaliação de famílias recentemente disponibilizadas permite verificar como o modelo funciona para além dos grupos familiares presentes em conjuntos de dados consolidados.
Para a previsão da estrutura terciária, a equipa desenvolveu o Zfold, adaptando as características aprendidas pelo structRFM a um modelo que prevê formas tridimensionais. Os autores comunicam melhorias tanto nas formas previstas como nas estruturas secundárias extraídas dessas previsões.
O Zfold foi avaliado em CASP15-natural, CASP16 e RNA-Puzzles, conjuntos de referência utilizados para avaliar a previsão de estruturas moleculares. Nestas avaliações, o artigo descreve o seu desempenho como comparável ao do AlphaFold3. A comparação diz respeito aos resultados do Zfold nos conjuntos de referência indicados, enquanto o structRFM fornece as representações de RNA subjacentes.
O estudo apresenta vários tipos de resultados positivos, em vez de uma única pontuação de precisão que abranja todas as aplicações. Reconhecer sequências relacionadas, prever pares de bases e reconstruir uma forma tridimensional são problemas diferentes, cada um exigindo a sua própria avaliação.
Do processamento do RNA à classificação funcional
O structRFM foi também testado em tarefas relacionadas com as funções do RNA. Estas incluíram a previsão de locais de splicing, a identificação de locais internos de entrada no ribossoma e a classificação de RNA não codificante, alargando a avaliação para além da forma molecular.
Os locais de splicing assinalam os limites utilizados pelas células no processamento das mensagens de RNA. Durante o splicing, algumas partes são removidas e as secções restantes são unidas. Prever esses limites ajuda os investigadores a analisar como é montada uma mensagem genética antes de ser utilizada para produzir uma proteína.
Os locais internos de entrada no ribossoma, ou elementos IRES, são regiões de RNA que permitem à maquinaria celular responsável pela produção de proteínas iniciar internamente a tradução. Identificá-los exige reconhecer padrões funcionais numa sequência, constituindo assim outro teste à informação captada durante o pré-treino.
Os RNA não codificantes desempenham funções que não consistem em servir de molde para a produção de proteínas. Classificá-los implica atribuir as moléculas aos grupos pertinentes. Os autores comunicam melhorias de desempenho nestas tarefas funcionais, mostrando que as representações aprendidas continuaram a ser úteis quando o alvo da previsão passou da estrutura para a função biológica.
A equipa também alargou o modelo à classificação de RNA não codificante longo, utilizando uma estratégia de segmentação. Dividir uma sequência longa em secções permite aplicar o modelo a entradas que, de outro modo, seriam difíceis de processar como uma única unidade.
O que a disponibilização aberta oferece aos investigadores
A disponibilização abrange três recursos com finalidades distintas. O conjunto de dados fornece os exemplos utilizados no treino. Os pesos do modelo contêm os valores numéricos aprendidos durante o treino. O código-fonte descreve a implementação e execução do software.
O acesso aos pesos permite aos investigadores utilizar um modelo já treinado, sem repetir todo o processo de pré-treino. O acesso aos dados e ao código permite analisar mais de perto o procedimento de treino, reproduzir experiências e desenvolver abordagens alternativas.
O artigo identifica o repositório do projeto no GitHub como heqin-zhu/structRFM. Indica também um arquivo Zenodo para o conjunto de dados de pré-treino, com o DOI 10.5281/zenodo.18272040, e um arquivo para o código-fonte e os pontos de controlo do modelo, com o DOI 10.5281/zenodo.18274292. Um DOI é um identificador persistente, concebido para permitir localizar um recurso de investigação ao longo do tempo.
A declaração sobre os dados refere que os conjuntos de dados de treino e teste estão disponíveis publicamente no repositório do projeto. Inclui também a divisão IRES processada utilizada no estudo e os dados de origem subjacentes às figuras. Os autores declaram que não existem restrições à disponibilidade dos dados.
Estes pormenores são importantes para as comparações. Os investigadores podem verificar quais os conjuntos de dados e as divisões utilizados, repetir as avaliações e testar se uma escolha de treino diferente altera os resultados. Assim, a disponibilização aberta permite escrutinar os resultados e reutilizar o modelo.
A equipa e o calendário da publicação
O trabalho foi desenvolvido na Escola de Engenharia Biomédica da USTC e no laboratório de imagiologia médica, robótica, computação analítica e aprendizagem, conhecido como MIRACLE. Os autores indicam afiliações em Hefei e no Instituto de Investigação Avançada de Suzhou da USTC. O coautor Ruifeng Li está ligado à Faculdade de Ciência e Tecnologia Informática da Universidade de Zhejiang, em Hangzhou.
Zhou, professor, e Xiong, investigador especial, conceberam e supervisionaram o estudo. Zhu concebeu e implementou a estrutura, realizou o pré-treino e várias experiências de previsão estrutural e classificação de RNA, e analisou os resultados. Outros membros da equipa trabalharam nos testes de homologia, nas comparações entre conjuntos de dados, na identificação de IRES e na avaliação estrutural.
A publicação e a divulgação pública do trabalho ocorreram em duas datas de calendário:
- 4 de novembro de 2026: a Nature indica a publicação de An open structure-guided RNA foundation model for generalizable prediction.
- 5 de novembro de 2026: o trabalho e a sua disponibilização aberta foram divulgados na China, tendo a publicação em linha sido descrita como ocorrida de madrugada.
Os autores indicam apoio da Fundação Nacional de Ciências Naturais da China, do Programa Nacional de Investigação e Desenvolvimento Fundamental, de programas de investigação em Jiangsu e Suzhou e do Projeto Sanming de Medicina, em Shenzhen. Declaram não ter interesses concorrentes.
O que os resultados mudam na investigação do RNA
O structRFM proporciona um ponto de partida comum para várias atividades de investigação. Um laboratório que estude o processamento do RNA pode adaptar o mesmo modelo subjacente que outro grupo utiliza para estudar a dobragem ou classificar moléculas não codificantes. Cada aplicação continua a exigir desenvolvimento e avaliação próprios para a tarefa em causa.
A combinação de 21 milhões de pares de treino, aprendizagem orientada pela estrutura e pontos de controlo disponibilizados oferece aos investigadores um sistema concreto para analisar, em vez de apenas uma descrição de um algoritmo. O MUSES e as experiências de mascaramento também apresentam opções de conceção específicas que outras equipas podem testar ou modificar.
Os resultados comunicados centram-se na previsão e classificação computacionais. A investigação com vista a aplicações biomédicas exigiria experiências biológicas adicionais, incluindo a verificação das estruturas previstas e o teste das funções atribuídas a moléculas específicas de RNA.
O artigo não indica um calendário para uma aplicação clínica. A mudança imediata é o acesso: investigadores de todo o mundo podem obter os recursos de treino, analisar a implementação e averiguar se os ganhos comunicados se aplicam aos seus próprios conjuntos de dados de RNA.
Pontos-chave
- Investigadores da USTC divulgaram o structRFM, um modelo-base de RNA treinado com cerca de 21 milhões de pares de sequências e estruturas secundárias.
- O modelo aprende padrões de sequência e relações de emparelhamento de bases e, em seguida, produz características apenas a partir da sequência de entrada.
- O MUSES combina fontes de previsão estrutural, enquanto o mascaramento dinâmico equilibra a informação estrutural e a dos nucleótidos durante o treino.
- Os autores comunicam resultados elevados na classificação de homologia e melhorias na previsão da estrutura secundária, incluindo testes com famílias de RNA recentemente disponibilizadas.
- O Zfold, adaptação do modelo para a previsão da estrutura terciária, obteve um desempenho descrito como comparável ao do AlphaFold3 em três conjuntos de referência indicados.
- O conjunto de dados, os pesos do modelo, o código-fonte e os recursos de avaliação estão disponíveis publicamente para reutilização e reprodução.